SQLazy 让复杂SQL开发少走90%弯路 写给每天和SQL死磕的你

- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
先聊聊日常:你是不是也在这样写SQL
从逻辑嵌套到跨库适配,从调试排错到历史交接,这些开发窘境你是否感同身受?
逻辑烧脑,嵌套成谜
业务需求层层加码,SQL嵌套七八层,逻辑盘根错节,写完自己都看不懂,执行结果频出意外。
调试漫长,耗时费力
排查错误需逐层拆解子查询,反复执行验证,调试时间往往远超编写代码本身,效率极低。
跨库适配,重复造轮
同一份业务逻辑需适配MySQL、Oracle、PostgreSQL等多种语法,纯体力重复劳动,维护成本高。
历史交接,如同"拆弹"
接手无注释、无文档的"祖传SQL",逻辑晦涩难懂,如同面对未知炸弹,不敢轻易修改,生怕牵一发而动全身引发系统故障。
工单排队,响应迟缓
数据查询与提取工单堆积如山,平均响应周期长达3-5天,数据无法实时获取,难以支撑业务的敏捷决策与快速迭代需求。
我们理想中的SQL开发,本该是什么样
如果写SQL能这么爽就好了:从繁琐的重复劳动中解放,回归逻辑构建的本质。
思路清晰
逻辑分步拆解,聚焦单一目标,思路线性清晰。
调试高效
支持查看中间结果,错误源头一键定位,大幅缩短调试周期。
跨库无忧
一套核心逻辑自动适配多数据库,无需手动修改语法。
交接轻松
逻辑自带可视化文档与注释,新人接手无沟通障碍。
人机协作
AI辅助基础代码优化,核心业务逻辑由开发者掌控。
- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
SQLazy是什么:不是AI写SQL,是编译SQL
一句话搞懂SQLazy的本质:用规范自然语言定义逻辑,确定性编译成原生SQL
逻辑你说了算
全程基于你定义的明确逻辑执行,业务逻辑主导权始终在开发者手中。
结果绝对可控
由确定性编译器生成最终SQL,输出结果稳定、可复现,消除不确定性。
输出纯原生SQL
最终产物是标准、纯净的原生SQL代码,无侵入应用在任何数据库环境中。
能力一:把嵌套SQL拆成“人话步骤”
告别多层嵌套,将复杂的业务逻辑转化为直观、线性的单步操作流。
思路清晰,线性可读
每一步仅执行单一操作,撰写时顺思路,阅读时无需层层解析。
降低门槛,拒绝烧脑
将复杂逻辑拆解为简单步骤,无需强行脑补上下文,上手即用。
灵活迭代,易于维护
需求变更仅需修改对应步骤,互不干扰,避免牵一发而动全身。
SQL
WITH s2 AS (
    SELECT CODE, DT, CL FROM stock WHERE CODE = 110838
)
SELECT MAX(连涨天数) AS 最长上涨天数
FROM (
    SELECT 不涨标记, COUNT(DT) AS 连涨天数
    FROM (
        SELECT CODE, DT, CL,
            SUM(CASE WHEN CL < col__3 THEN 1 ELSE 0 END) OVER (
                ORDER BY CASE WHEN DT IS NULL THEN 1 ELSE 0 END, DT ASC
            ) + 1 AS 不涨标记
        FROM (
            SELECT s2.*, LAG(CL) OVER (
                ORDER BY CASE WHEN DT IS NULL THEN 1 ELSE 0 END, DT ASC
            ) AS col__3
            FROM s2
        ) sub__4
    ) s3
    GROUP BY 不涨标记
) s4
SQLazy
| 命名 | 锚点 | 语句 |
|---|---|---|
| s1 | stock | 筛选 CODE 等于 110838 |
| s2 | 排序 DT 升序 | |
| s3 | 分段 CL 变小 命名 不涨标记 | |
| s4 | 汇总 DT 计数 命名 连涨天数 分组 不涨标记 | |
| 汇总 连涨天数 最大 命名 最长上涨天数 |
能力二:逐步调试看中间结果,找bug快10倍
不用再手动拆SQL,每一步结果都看得见,让数据调试流程像代码开发一样清晰可控。
实时预览中间结果
点击任意步骤,直接查看对应中间表的完整数据,无需手动拆分执行。
精准锁定错误源头
无论是过滤条件出错还是计算逻辑偏差,都能当场定位问题环节。
调试效率量级跃升
沿用代码调试的成熟逻辑,将传统“盲猜+试错”升级为可视化、可追溯的高效流程。
彻底告别低效循环
终结“写半小时SQL,调一小时bug”的困境,聚焦业务逻辑构建与优化。

能力三:一套逻辑,多库编译
一次写清业务逻辑,自动适配所有数据库方言,实现跨平台无缝开发。
一键切换目标源
基于统一的逻辑描述,无需修改核心代码,即可一键切换运行的目标数据库环境。
全栈主流平台兼容
原生支持MySQL、Oracle、PG等业界主流数据库 以及Hive、Spark、Snowflake等数仓平台。
语法细节自动兼容
自动处理不同数据库的函数差异、数据类型转换及窗口函数特性。
消除重复体力劳动
彻底告别“同一业务逻辑,为适配不同数据库写N个SQL版本”的低效模式。
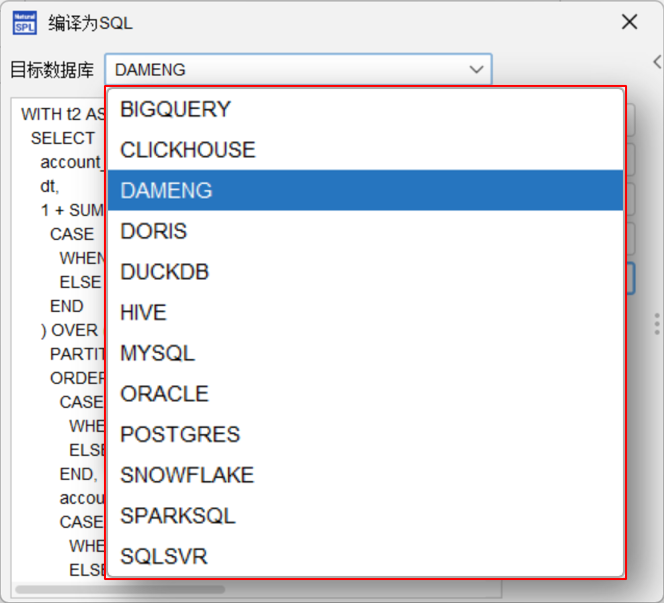
支持多种目标数据库,一键编译
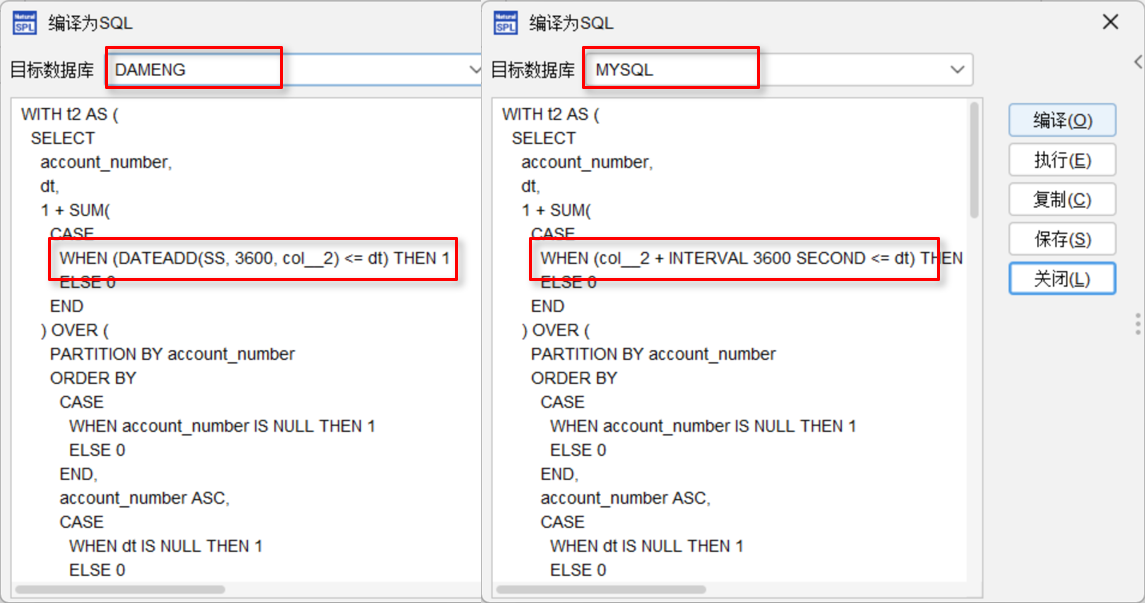
自动屏蔽方言差异,无缝切换
能力四:逻辑即文档,代码资产化易传承
写出来的步骤,直接就是开发文档,让每一行逻辑都清晰可见、有据可依。
天然注释
步骤列表本身就是清晰的计算说明,无需额外编写繁琐注释,实现逻辑与说明的自然融合。
易于理解
无论新人接手还是后期回溯,直接阅读可视化步骤流程,即可快速掌握完整业务逻辑。
代码资产化
将临时工单转为标准化步骤资产,历史逻辑不再晦涩,复用仅需调整关键参数即可适配。
知识沉淀
核心业务逻辑固化为文档资产,避免人员流动导致的知识流失,新人可直接复用最佳实践。
- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
AI辅助:SQLazy如虎添翼
AI辅助:只做语法转译,不抢逻辑决策权
AI是专业打字员,而非业务逻辑的决策者,让技术服务于思维而非替代思维
步骤1 – 自然语言描述
使用更灵活的口语描述计算步骤(如:找出CODE是110838的数据)
步骤2 – AI规范语句
AI将口语转换成规范语句(如:筛选 (CODE 等于 110838))
步骤3 – 编译生成SQL
编译器生成可执行SQL
AI编程工具 × SQLazy 双引擎协同
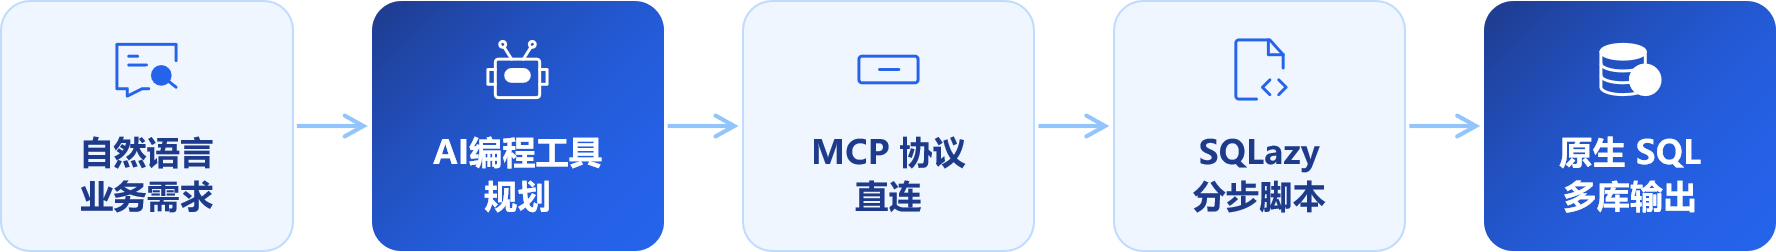
MCP 协议直连
IDE 内零配置调用
结果自动校验
内存表数据即时验证
知识库继承
SKILL 沉淀可复用
协同效果:从开盲盒到可控工程
手写 SQL
逻辑可读性:多层嵌套结构晦涩难懂,逻辑表达隐晦不明,完全依赖开发者个人编码习惯,新成员接手项目极难快速理解
调试与维护:需手动拆解复杂子查询定位问题,历史代码无文档支撑,后续迭代修改与系统维护的人力与时间成本极高。
多库适配:跨数据库适配需手工改写,属于重复低效劳动,结果完全依赖个人技术能力,极易出现语法与逻辑错误。
普通 AI SQL 工具
逻辑可读性:AI生成逻辑随机发挥无固定规范,输出结果不可控,推导过程呈黑盒化,难以理解其逻辑来源与合理性。
调试与维护:生成过程是黑盒机制,出错后无法追溯排查原因,代码无维护性,无法进行长期的迭代与复用优化。
适配与可靠性:存在AI幻觉问题,生成结果不稳定,多数据库适配能力弱,无法保障业务逻辑的准确性与安全性。
AI + SQLazy 协同
逻辑可读性:分步逻辑清晰透明,以可视化步骤生成标准SQL结构,规范统一且可追溯,团队成员均可快速理解上手。
调试与维护:每一步操作均可独立验证与回查,问题可精准定位;操作步骤即天然文档,后续维护与迭代成本极低。
适配与可靠性:编译级校验保证结果100%正确,支持多数据库一键自动适配切换,彻底消除AI幻觉,稳定支撑业务。
倒译历史复杂SQL:祖传代码起死回生
痛点一:代码黑盒
祖传SQL嵌套层级深、逻辑晦涩难懂,原开发人员离职后无人敢接手,成为系统维护的“烫手山芋”。
痛点二:AI解读局限
只用AI仅能生成静态说明文档,无法随SQL迭代同步更新,文档与实际代码逐渐脱节,失去参考价值。
痛点三:AI修改风险
AI直接改写生成的SQL易偏离原始业务规则,逻辑一致性难以保证,直接用于生产环境存在极高的业务风险。
倒译工作流程图
从祖传SQL到可维护资产的完整链路
01 祖传SQL输入
接收复杂SQL脚本(支持多方言),作为倒译数据源
02 AI语义解析
拆解嵌套查询与隐式逻辑,识别计算规则与业务指标关系
03 生成分步脚本
输出结构化的SQLazy脚本,将黑盒逻辑转为易读的任务流
04 人工审核校验
业务专家审核逻辑,确保脚本与业务需求一致
05 小数据量验证
用测试数据对比新旧输出,验证逻辑与数据一致性
06 编译原生SQL
将验证后的脚本编译为目标数据库的规范原生SQL
07 资产闭环维护
后续变更基于SQLazy脚本,形成可复用、可追溯的资产闭环
AI编程工具 + SQLazy实践
SQL 规划 · 正向
SQLazy 分步逻辑
- t1 合计订单金额,按月份分组
- t2 分段标记连续上涨区间
- t3 计算每段持续月数
- t4 取最大值 → 最长连续上涨 4 个月
SQL 倒译 · 反向
SQLazy 分步逻辑
- t1 外键穿越取数 订单/零件/供应商/国家/零件供应
- t2 计算年份(订单日期)
- t3 筛选零件名称含"轴"
- t4 汇总总利润,按国家、年份分组
- t5 按国家、年份降序输出
- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
应用结构
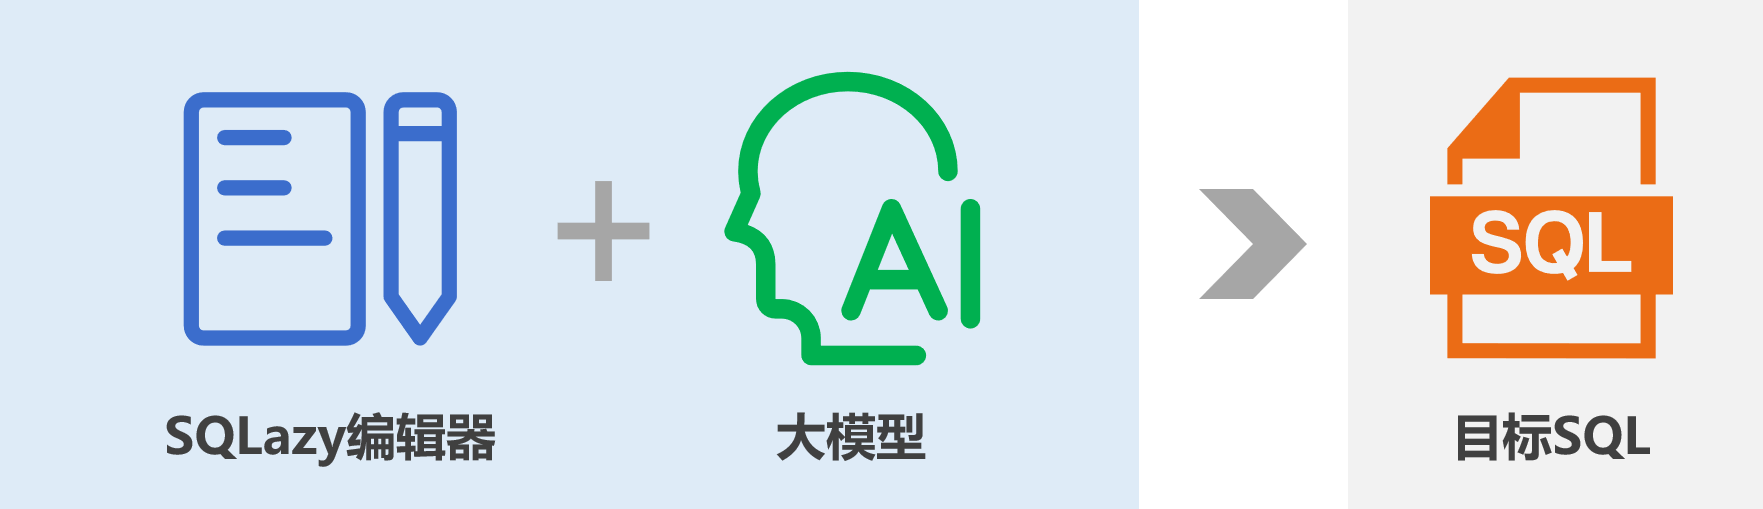
仅生成SQL,无代码嵌入生产系统,零架构风险
桌面IDE易上手
步骤编辑
可视化编辑Workflow步骤,内置语法高亮、智能帮助功能,大幅降低脚本编写门槛。
结果预览
点击任意步骤即可即时查看对应中间结果,实现开发调试零成本试错。
SQL编译
实时编译生成原生SQL代码,一键切换MySQL、PostgreSQL等目标数据库。
LLM配置
灵活接入大模型API密钥,辅助规范查询语句。
全本地运行,数据零泄露
全程本地环境运行,数据不出内网,支持完全离线使用,从源头保障企业数据安全。
私有大模型,无限AI辅助
支持接入企业自有大模型服务,AI代码建议、优化无调用次数限制,成本可控且响应更快。
内置引擎,百万级数据调试
集成SPL计算引擎,可在本地轻松处理百万级数据集,验证逻辑效率远高于传统数据库。

企业级安全与部署
为大型组织提供安全、可控、高效的SQL开发,全方位保障数据资产安全与业务合规
01 完全私有化部署
支持将平台核心服务部署在企业内部网络环境,实现物理层面的隔离管控。从源头杜绝外部访问风险,满足金融、政务等强监管行业对数据本地化的合规要求。
02 数据全链路内网闭环
所有SQL智能分析和调试编译均在企业内网完成,数据交互不经过公网传输。彻底规避数据泄露、中间人攻击等风险,确保核心业务数据安全。
03 国产大模型生态适配
深度兼容主流国产大模型,支持私有化部署模型的无缝对接。完美契合信创体系建设要求,实现技术自主可控与安全合规的双重保障。
04 非侵入式无感集成
无任何运行组件侵入生产系统,无需改造现有数据库及应用架构。快速对接现有开发体系,零风险保障业务连续性并获得开发效率提升。
- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
SQLazy特别适用数据查询工单场景
传统数据工单场景存在的瓶颈
效率瓶颈
需求排队严重,平均响应周期长达3-5天,难以支撑及时决策
维护瓶颈
没人能快速读懂一段200行的生产SQL,交接与维护成为灾难
成本瓶颈
人员被消耗在繁琐重复的SQL编写上,高级人才无法投身于深度分析与战略洞察
工单场景:SQLazy的核心价值
及时性
解决AI写SQL麻烦、调试难的问题,快速响应业务需求
正确性
分步调试确保结果准确,解决审计难的问题
临时性
无需为AI准备复杂的测试案例,即可快速生成临时查询
协助业务理解
业务用户可直观确认逻辑步骤,实现高效沟通
资产化可传承
工单逻辑自动沉淀为可复用资产,实现团队经验的持续迭代
工单资产库:让每一份工单都不白做
从一次性劳动到可复用资产的转变,打造团队可持续的数字化生产力
交付即沉淀
工单脚本归档,附带业务标签与口径说明,成果转为可回溯、可审计的数字资产。
智能检索复用
新需求检索匹配历史脚本,调整脚本即可交付,避免重复造轮子。
团队经验传承
新人通过资产库学习标准脚本与口径,快速上手,实现技术经验无缝传递。
持续迭代优化
资产库脚本持续打磨,沉淀为团队最佳实践,整体效率与数据质量稳步提升。
01 效率提升10倍
02 质量提升100%
03 成本降低60%
SQLazy:面向数据库移植场景
现有移植方案
方案一:兼容模式
✔ 优点
几乎无需改造,上线快,适用于SQL简单的TP业务。
✘ 缺点
兼容覆盖度有限,对复杂语法的AP业务支持不佳;临时解析导致性能不稳定。
方案二:AI改写
✔ 优点
可生成目标数据库的原生SQL,充分发挥其能力。
✘ 缺点
大语言模型存在幻觉问题,对复杂逻辑的SQL出错率高,人工审核成本高昂。
SQLazy方案:AI驱动的逻辑资产化路径
以更低成本、更高效率,确保逻辑100%保真
AI理解与翻译
利用AI将复杂SQL转化为结构化的SPEC脚本
人工审核与验证
通过单步执行直观验证,确保逻辑准确无误
SQLazy编译生成
将SPEC脚本精准编译为目标数据库的原生SQL
效率更高
自动化测试流程排错审核,迁移周期缩短50%以上
成本更低
结构化步骤易于调试和审计,大幅降低人工成本
资产沉淀
将SQL转化为可复用、可维护的企业逻辑资产
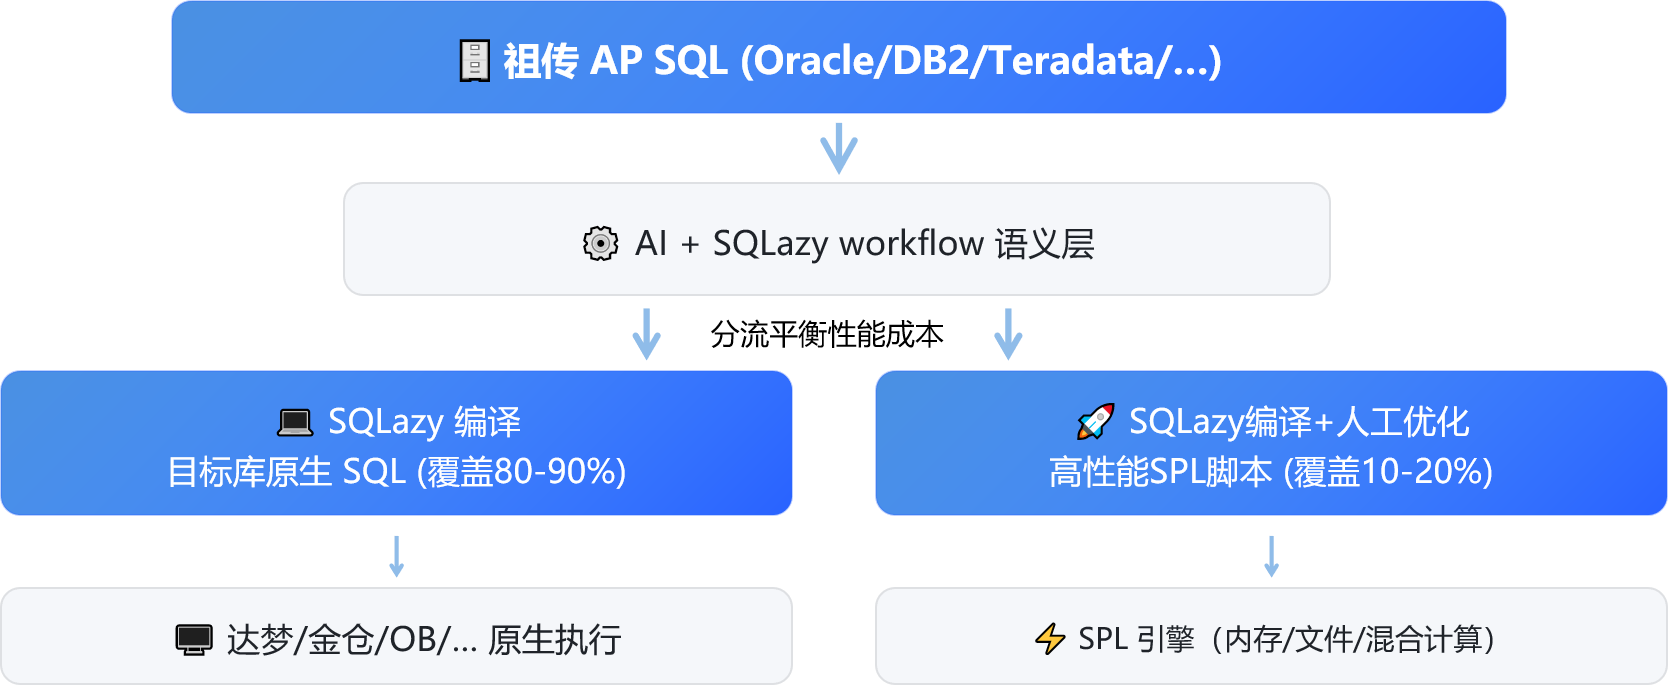
SQLazy+SPL:兜底移植后的性能问题
部分SQL移植后可能会有性能锐降的现象,单纯优化SQL不可解。SQLazy的核心引擎SPL可实现更多高性能算法,获得10倍性能提升
- 01痛点与愿景
- 02SQLazy是什么
- 03AI协同与倒译
- 04应用结构方案
- 05应用场景深潜
- 06更多实战示例
更多示例
| ID | Date | Invoiced | Amount |
|---|---|---|---|
| AAA | 2023-01 | 0 | 10 |
| AAA | 2023-02 | 0 | 15 |
| AAA | 2023-03 | 1 | 15 |
| AAA | 2023-04 | 0 | 10 |
| AAA | 2023-05 | 0 | 10 |
| AAA | 2023-06 | 1 | 10 |
| BBB | 2022-05 | 0 | 40 |
| BBB | 2022-06 | 1 | 20 |
| BBB | 2022-07 | 0 | 30 |
| BBB | 2022-08 | 1 | 30 |
| ID | Date | Invoiced | Amount |
|---|---|---|---|
| AAA | 2023-03 | 1 | 40 |
| AAA | 2023-06 | 1 | 30 |
| BBB | 2022-06 | 1 | 60 |
| BBB | 2022-08 | 1 | 60 |
只保留开票行(invoiced=1),每行 Amount 是自上次开票以来的累计值
| 命名 | 锚点 | 语句 |
|---|---|---|
| t1 | invoice | 排序 id,dt 降序 |
| t2 | 计算列 invoiced 累计 命名 grp 分区 id | |
| t3 | 汇总 dt 最大 命名 dt, invoiced 最大 命名 invoiced, amount 合计 命名 amount 分组 id, grp | |
| t4 | 导出表 id dt invoiced amount |
WITH invoice_groups AS (
	SELECT id, dt, invoiced, amount,
    	SUM(invoiced) OVER (PARTITION BY id ORDER BY CASE WHEN id IS NULL THEN 1 ELSE 0 END, id ASC, dt DESC ROWS UNBOUNDED PRECEDING) AS grp
  	FROM invoice
),
aggregated AS (
  	SELECT id, grp, MAX(dt) AS dt, MAX(invoiced) AS invoiced, SUM(amount) AS amount
  	FROM invoice_groups
  	GROUP BY id, grp
)
SELECT id, dt, invoiced, amount
FROM aggregated
ORDER BY id, grp
| account_number | dt | seq |
|---|---|---|
| 19 | 2024-04-03 07:02:02 | 1 |
| 19 | 2024-04-03 07:02:41 | 2 |
| 19 | 2024-04-03 14:58:49 | 1 |
| 19 | 2024-04-03 19:58:49 | 1 |
| 19 | 2024-04-05 14:58:49 | 1 |
| 19 | 2024-04-05 14:59:31 | 2 |
| 19 | 2024-04-17 23:56:13 | 1 |
| 19 | 2024-04-18 00:15:13 | 2 |
| 19 | 2024-04-18 14:56:13 | 1 |
| 19 | 2024-04-19 07:41:55 | 1 |
| 19 | 2024-04-19 07:42:20 | 2 |
| 19 | 2024-04-19 08:41:20 | 3 |
| 20 | 2024-04-17 23:59:13 | 1 |
| 20 | 2024-04-18 07:41:55 | 1 |
| 20 | 2024-04-18 19:41:55 | 1 |
| 20 | 2024-04-18 19:56:55 | 2 |
需要根据前两列生成一个序列号 Seq:
- 按账户分组,按日期时间升序处理
- 如果当前行的活动时间与上一行的时间间隔超过 1 小时,则序列号重置为 1
- 否则(间隔 ≤ 1 小时),序列号递增 1
| 命名 | 锚点 | 语句 |
|---|---|---|
| t1 | numEvents | 排序 account_number 升序 dt 升序 |
| t2 | 分段 条件 ((dt [-1] 偏移 3600 秒) <= dt) 分区 account_number 命名 grp | |
| t3 | 计算列 # 命名 seq 分区 account_number grp | |
| t4 | 导出表 删除 grp |
WITH t1 AS (
  SELECT account_number, dt FROM numEvents
),
t2 AS (
  SELECT account_number, dt,
    1 + SUM(CASE WHEN (col__5 + INTERVAL 3600 SECOND <= dt) THEN 1 ELSE 0 END)
      OVER (PARTITION BY account_number ORDER BY account_number ASC, dt ASC) AS grp
  FROM (
    SELECT t1.*,
      LAG(dt) OVER (PARTITION BY account_number ORDER BY account_number ASC, dt ASC) AS col__5
    FROM t1
  ) sub__6
)
SELECT
  ROW_NUMBER() OVER (PARTITION BY account_number, grp ORDER BY account_number ASC, dt ASC) AS seq,
  dt,
  account_number
FROM t2
ORDER BY account_number ASC, dt ASC
| ID | SPLIT | CUST | DATE | AMOUNT |
|---|---|---|---|---|
| ID_1 | SPLIT_YES | A | 2024-05-01 00:00:00 | 100 |
| ID_1 | SPLIT_NO | A | 2024-04-01 00:00:00 | 200 |
| ID_1 | SPLIT_YES | B | 2024-03-01 00:00:00 | 50 |
| ID_2 | SPLIT_YES | A | 2024-05-01 00:00:00 | 50 |
| ID_2 | SPLIT_NO | A | 2024-04-01 00:00:00 | 300 |
| ID_2 | SPLIT_NO | B | 2024-03-01 00:00:00 | 300 |
| ID_3 | SPLIT_YES | B | 2024-04-01 00:00:00 | 90 |
| ID_3 | SPLIT_NO | B | 2024-04-01 00:00:00 | 30 |
| ID_3 | SPLIT_NO | A | 2024-04-01 00:00:00 | 10 |
| ID_3 | SPLIT_NO | A | 2024-03-01 00:00:00 | 10 |
| ID | SPLIT | CUST | DATE | AMOUNT |
|---|---|---|---|---|
| ID_1 | SPLIT_NO | A | 2024-04-01 00:00:00 | 200 |
| ID_1 | SPLIT_YES | A | 2024-05-01 00:00:00 | 150 |
| ID_2 | SPLIT_NO | A | 2024-04-01 00:00:00 | 600 |
| ID_2 | SPLIT_YES | A | 2024-05-01 00:00:00 | 50 |
| ID_3 | SPLIT_NO | A | 2024-04-01 00:00:00 | 20 |
| ID_3 | SPLIT_NO | B | 2024-04-01 00:00:00 | 30 |
| ID_3 | SPLIT_YES | B | 2024-04-01 00:00:00 | 90 |
对数据表按ID和SPLIT字段分组后,根据组内日期是否重复来决定是否进一步按CUST分组,并汇总金额保留最近日期的记录。
| 命名 | 锚点 | 语句 |
|---|---|---|
| t2 | splitAcc | 排名 DT 降序 中式 命名 rnk 分区 ID SPLIT |
| t3 | 计算列 if (rnk = 1 then CUST else null) 命名 rnk1 分区 ID SPLIT | |
| t4 | 计算列 AMOUNT 合计 命名 total_amount, rnk1 唯一计数 命名 num_cust 分区 ID SPLIT | |
| t5 | 计算列 AMOUNT 合计 命名 total_cust_amount 分区 ID SPLIT CUST | |
| t6 | 计算列 if (num_cust = 1 then total_amount else total_cust_amount) 命名 amt | |
| t7 | 筛选 rnk = 1 | |
| 导出表 ID SPLIT CUST DT amt |
WITH ranked AS (
  SELECT
    sub__13.*,
    DENSE_RANK() OVER (PARTITION BY ID, SPLIT ORDER BY DT DESC) AS rnk
  FROM splitAcc sub__13
),
with_totals AS (
  SELECT
    ID, SPLIT, CUST, DT, AMOUNT, rnk,
    CASE WHEN rnk = 1 THEN CUST ELSE NULL END AS rnk1,
    SUM(AMOUNT) OVER (PARTITION BY ID, SPLIT) AS total_amount,
    COUNT(DISTINCT CASE WHEN rnk = 1 THEN CUST ELSE NULL END) OVER (PARTITION BY ID, SPLIT) AS num_cust,
    SUM(AMOUNT) OVER (PARTITION BY ID, SPLIT, CUST) AS total_cust_amount
  FROM ranked
)
SELECT
  ID, SPLIT, CUST, DT,
  CASE WHEN num_cust = 1 THEN total_amount ELSE total_cust_amount END AS amt
FROM with_totals
WHERE rnk = 1
| InvoiceID | Amount | ProjectID |
|---|---|---|
| 1 | 100.0000 | 1 |
| 2 | 100.0000 | 2 |
| 3 | 100.0000 | 3 |
| 4 | 100.0000 | 4 |
| ID | ProjectID | AccountCode |
|---|---|---|
| 1 | 1 | 12345 |
| 2 | 2 | 12345 |
| 3 | 2 | 7890 |
| 4 | 3 | 800 |
| 5 | 3 | 234 |
| 6 | 3 | 987 |
| 7 | 4 | 800 |
| 8 | 4 | 234 |
| 9 | 4 | 987 |
| 10 | 4 | 2579 |
| InvoiceID | Amount | ProjectID | AccountCode | SplitAmount |
|---|---|---|---|---|
| 1 | 100.0 | 1 | 12345 | 100.0 |
| 2 | 100.0 | 2 | 12345 | 50.0 |
| 2 | 100.0 | 2 | 7890 | 50.0 |
| 3 | 100.0 | 3 | 800 | 33.34 |
| 3 | 100.0 | 3 | 234 | 33.33 |
| 3 | 100.0 | 3 | 987 | 33.33 |
| 4 | 100.0 | 4 | 800 | 25.0 |
| 4 | 100.0 | 4 | 234 | 25.0 |
| 4 | 100.0 | 4 | 987 | 25.0 |
| 4 | 100.0 | 4 | 2579 | 25.0 |
关联连个表,将发票金额按项目下的账户数平均分账,金额保留两位小数,最后一个账户分剩余的钱,保证总和不变。
| 命名 | 锚点 | 语句 |
|---|---|---|
| t1 | numEvents | 拼接 projectid; 关联表 invoices; projectid; 拼接列 invoiceid amount |
| t2 | 排序 accountcode 升序 | |
| t3 | 计算列 invoiceid 计数 命名 cnt, round (amount /cnt, 2) 命名 splitamount 分区 projectid | |
| t4 | 计算列 splitamount 合计 命名 saa, if (# = 1 then round (splitamount + amount - saa,2) else splitamount) 命名 f1 分区 projectid | |
| t5 | 导出表 invoiceid amount accountcode projectid f1 命名 splitamount | |
| t6 | 排序 invoiceid 升序 accountcode 升序 |
WITH joined AS (
  SELECT p.id, p.projectid, p.accountcode, i.invoiceid, i.amount
  FROM projects p
  LEFT JOIN invoices i ON p.projectid = i.projectid
),
with_count AS (
  SELECT *,
    COUNT(invoiceid) OVER (PARTITION BY projectid) AS cnt
  FROM joined
),
with_split AS (
  SELECT *,
    ROUND(amount / cnt, 2) AS splitamount
  FROM with_count
),
with_sum AS (
  SELECT *,
    SUM(splitamount) OVER (PARTITION BY projectid) AS saa
  FROM with_split
),
adjusted AS (
  SELECT *,
    CASE
      WHEN ROW_NUMBER() OVER (PARTITION BY projectid ORDER BY accountcode ASC) = 1
      THEN ROUND(splitamount + amount - saa, 2)
      ELSE splitamount
    END AS f1
  FROM with_sum
)
SELECT invoiceid, amount, accountcode, projectid, f1 AS splitamount
FROM adjusted
ORDER BY invoiceid ASC, accountcode ASC
你最关心的:学习成本高吗?
半天就能上手,不用推翻现有习惯,让学习过程轻量又高效
核心概念极简,上手极速
基础运算不到20个,沿用熟悉的SQL核心概念,仅替换为更直观的写法。
真实场景示例库
多个覆盖各行业的真实业务场景示例,无需从零构建,即可快速上手。
兼容现有能力,而非替代
它不是要你抛弃纯粹的SQL技能,而是为你提供一套更高效的逻辑组织方式。
无缝融入现有工作流
最终输出的是标准原生SQL语句,可直接在现有数据库、BI工具中运行,与各类数据平台完全兼容。
怎么开始用:零门槛上手
现在就能试,不用等部署,多种方式适配不同使用场景。
网页在线版:即用即开,快速验证
无需注册登录,打开浏览器即可使用,适合快速验证需求、生成临时查询语句。
桌面IDE版:本地调试,功能无界
支持本地大数据量调试,可接入企业自有大模型与私有知识组织,数据处理更安全。
无缝集成:兼容全栈工具生态
生成标准的SQL代码,可直接复制粘贴到任意查询编辑器、任务调度系统或BI分析工具中。
无感融入:保留现有工作流程
不入侵现有数据架构,完全尊重团队已有的协作方式和技术栈,让AI能力成为工作流中的“隐形助手”。
SQLazy让SQL开发更简单高效
在线体验
访问 sqlazy.com 即可立即在线试用,无需注册账号,平台所有核心功能均免费开放使用。
文档与示例库
github.com/SPLWare/SQLazy 提供完整的函数文档与功能说明,覆盖数十个真实业务场景的SQL实战示例,助你快速上手。
问题与建议反馈
使用中若遇到问题或有改进建议,欢迎通过社区论坛联系我们,期待你的反馈。