- 跑批任务提前完成,从容应对后续任务
- 查询报表秒出,优化用户体验
- 预计算成为历史,改变业务模式
集算器 SPL
快到没机会集群的计算技术
01集算器是什么?
集算器 SPL 是什么?
- 数据计算引擎
- 结构化和半结构化数据计算处理
- 线下跑批、在线查询
- 既非SQL体系,也非NoSQL技术
- 自创SPL语法,简洁高效
SPL: Structured Process Language
集算器 SPL 应对什么痛点?
面向线下跑批、在线查询等数据计算场景
- 时间窗口不够,半夜跑批跑不完,出错来不及重来;月末年头担惊受怕
- 出个报表十分钟,业务人员拍桌子;预计算难预测,业务人员不满意
- 并发用户多一点,时间跨度长一点,数据库就像死了一样
- 动不动分布式集群,硬件资源消耗巨大,运维复杂度高
- 数据库存储空间昂贵,还要不断地扩容
- ……

集算器 SPL 对标什么?
采用SQL语法的、应用于OLAP场景的数据库
- 常规数据库:MySQL、PostgreSQL、Oracle、DB2、…
- Hadoop上的数据仓库:Hive、Spark SQL、…
- 分布式数据仓库/MPP,HTAP数据库,内存数据库
- 逻辑数据仓库,云数据仓库
- 数据库一体机:ExaData、…
其它数据分析与统计技术
- Python, Spark/Scala, Java, …
集算器 SPL
- 低代码
- 高性能
- 轻量级
- 全功能
快到没机会集群的计算技术
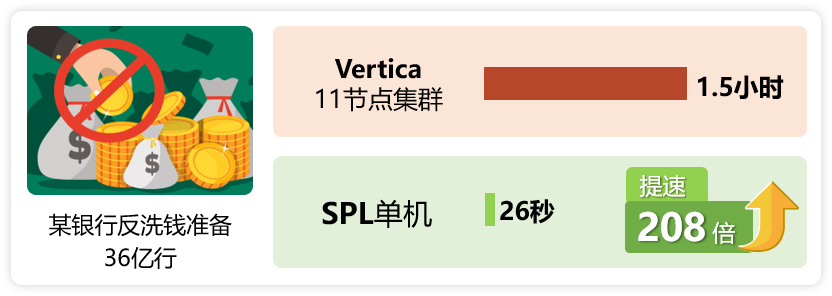
令国产芯片飞起的程序语言
TPCH100G 8C32G
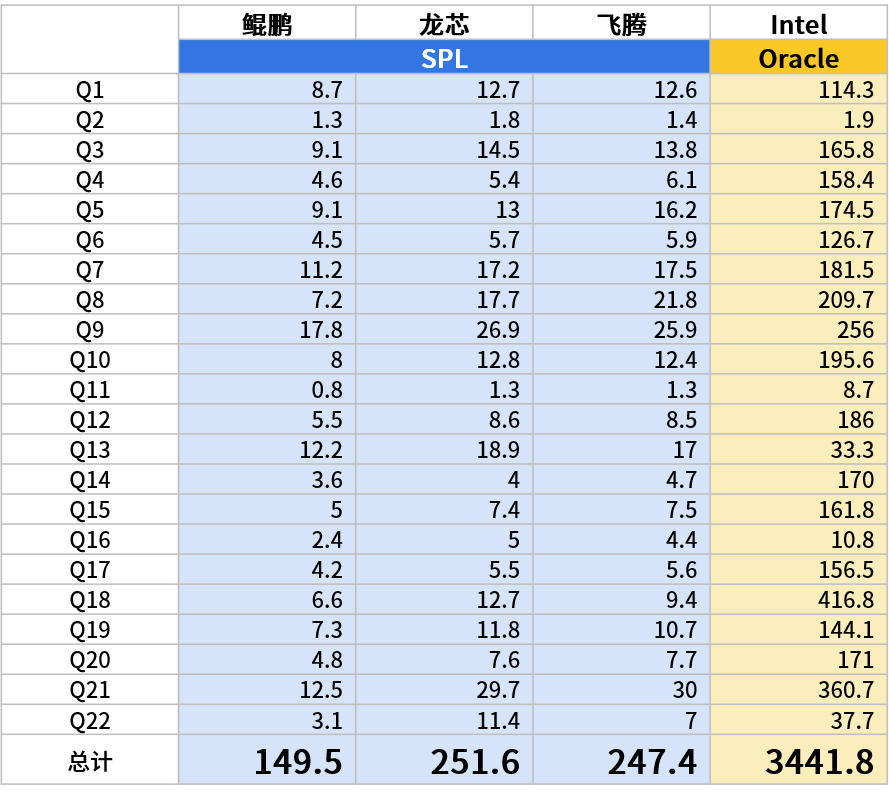
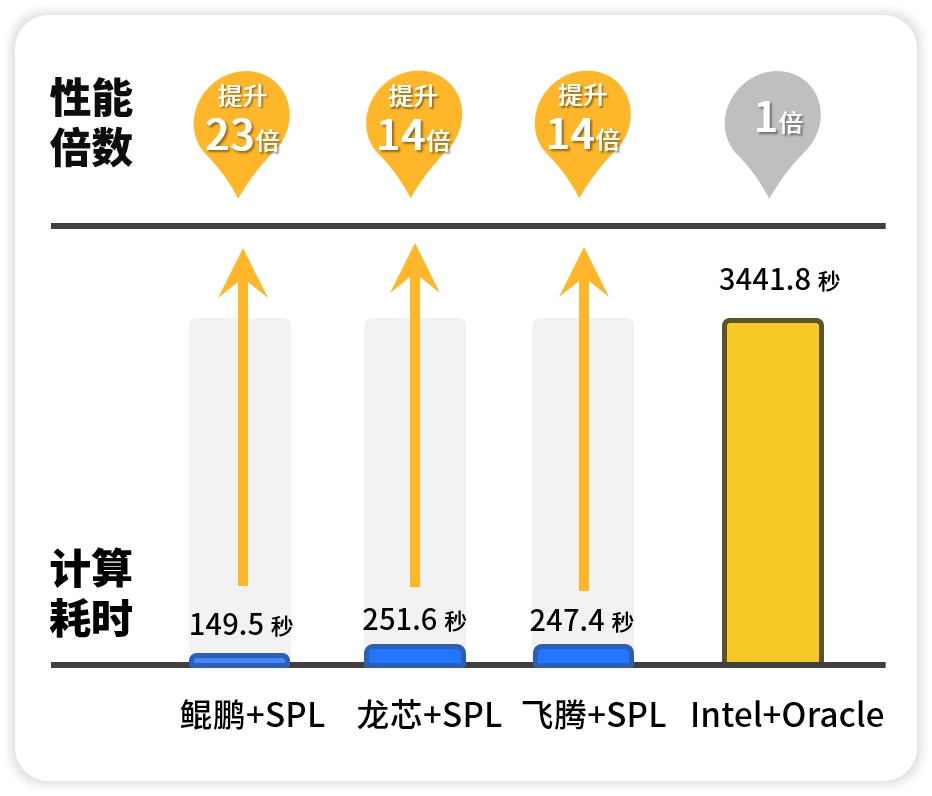
集算器 SPL 带给用户的价值
性能
提升N倍
成本
减少N倍
- 单机顶集群,更少硬件资源消耗和运维成本
- 无需专业的数据库存储,普通文件系统和低费用云存储上就能跑出高性能
02案例简析
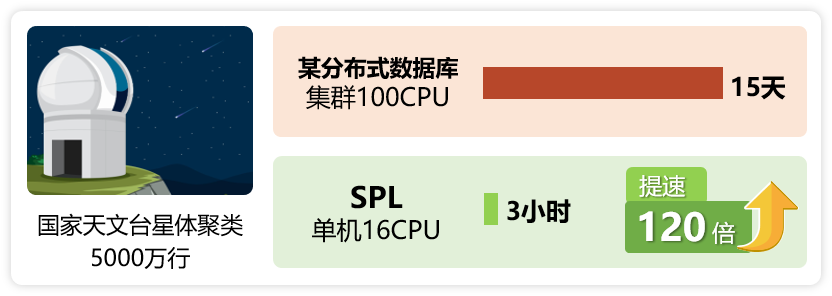
案例国家天文台星体聚类
问题与难点
- 11张照片,每张500万天体
- 天文规则(三角函数计算)聚类
- 平方级复杂度,500万*500万*10=250万亿次对比
- 50万天体测试
- Python 200行,单线程 6.5天
- SQL 100CPU集群 3.8小时
- 50万天体测试, 2.5分钟
- 500万天体, 3小时
- 代码 50行
提速
2000 倍
案例手机银行多并发帐户查询
问题与难点
- 用户多,并发访问量大
- 机构信息经常变更,需要及时关联
- Hadoop上商用数仓无法满足高并发要求
- 换用6台ElasticSearch集群能应对并发,但不能实时关联,数据更新时间长,期间只能停止服务
- 单机做到ES集群同样并发量
- 实时关联,机构信息更新零等待
1 台 顶 6 台
案例某银行对公贷款业务跑批
问题与难点
- 48个SQL步骤,3300行
- 历史数据量1.1亿行,每日新增137万行
- 复杂多表关联
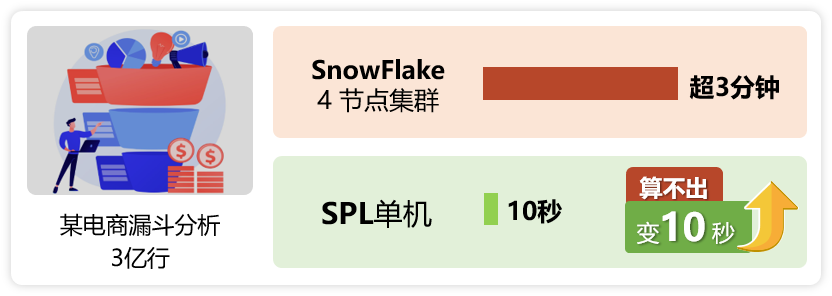
案例电商漏斗转化率分析
问题与难点
- 用户数约1000万,单月事件量约4亿行
- 按照事件发生顺序计算去重用户数
- Snowflake Medium型4节点集群
- 3步漏斗3 分钟没出来,用户放弃
- SQL代码复杂难懂,更多步骤的漏斗还要增加子查询
- 单机10秒完成计算
- 代码量减少,更多步骤漏斗不用增加代码
3分钟算不出
到10秒
到10秒
案例某银行贷款去重户数指标统计
问题与难点
- 标签众多,数百个标签任意组合查询
- 2000万行大表及更大的明细表关联、过滤、汇总计算
- 每个页面涉及近200指标计算,10并发共2000多指标同时计算
- Oracle
- 无法实时计算,只能预先约定查询要求,提前一天预计算
- 10并发共2000指标计算不到3秒
- 无需预先准备,临时选择任意标签组合,实时查询结果
预计算变实时计算
03集算器凭什么?
SQL为什么跑不快:1亿条数据取前10名
SELECT TOP 10 * FROM Orders ORDER BY Amount DESC
这个查询用了ORDER BY,严格按此逻辑执行,意味要将全量数据做排序,性能将很差
我们知道有不必全排序而完成这个运算的办法,但用SQL无法描述,只能寄希望于数据库的优化引擎
简单情况(比如本句),很多数据库都能优化,但情况再复杂一些,数据库优化引擎就会晕了
下面的分组内取前N名,SQL无法直接描述了,还是要采用迂回思路利用窗口函数写成子查询
面对这种迂回写法,数据库优化引擎也不会优化了,只能去执行排序
SELECT * FROM (
    SELECT *, ROW_NUMBER() OVER (PARTITION BY Area ORDER BY Amount DESC) rn
    FROM Orders )
WHERE rn<=10
SQL为什么难写:一支股票最长连涨了多少天
SELECT MAX(ContinuousDays)
FROM (SELECT COUNT(*) ContinuousDays
    FROM (SELECT SUM(UpDownTag) OVER ( ORDER BY TradeDate) NoRisingDays
        FROM (SELECT TradeDate,
            	CASE WHEN Price>LAG(price) OVER ( ORDER BY TradeDate)
                	THEN 0 ELSE 1 END UpDownTag
            FROM Stock ) )
    GROUP BY NoRisingDays )
SQL对有序运算支持不足,未直接提供有序分组,只能采用迂回思路,写成四层嵌套的形式
这样的句子不仅很难写出来,写出来想看懂也不容易
面对复杂的业务逻辑,SQL的复杂度会陡增,既难懂又难写
这并非罕见需求,现实中数千行的SQL代码中这种情况比比皆是,严重影响开发和维护效率
SPL的解决方法
| A | ||
| 1 | =file(“Orders.ctx”).open().cursor() | |
| 2 | =A1.groups(;top(10;-Amount)) | 金额在前10名的订单 |
| 3 | =A1.groups(Area;top(10;-Amount)) | 每个地区金额在前10名的订单 |
SPL将TopN视为返回集合的聚合运算,避免全排序;全集和分组时写法类似,不再迂回
| A | |
| 1 | =Stock.sort(TradeDate).group@i(Price< Price[-1]).max(~.len()) |
股票连涨:这句SPL和前面SQL的运算逻辑相同,但SPL提供有序分组运算,描述起来直观简洁
玩爆SQL的常见场景
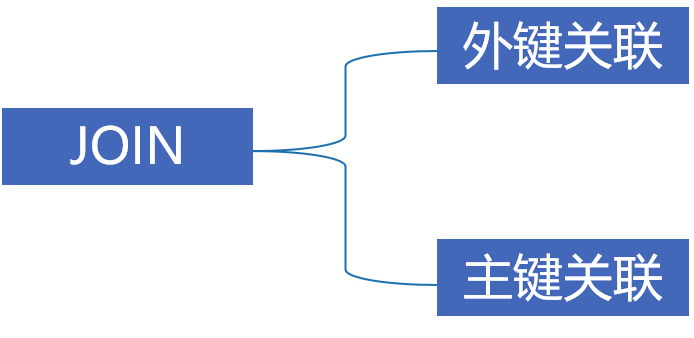
1、多表关联运算:多层维表,主子事实表,带条件关联
- SQL不区分JOIN类型,不能利用主键特性
- 宽表冗余存储,IO访问量大且数据准备复杂
2、账户行为分析,对象事件计算:漏斗统计、碰撞分析
- 跨行有序计算,SQL对有序运算和存储支持不足,要写成大表JOIN,性能极其低下
- DISTINCT/COUNT DISTINCT 要保持大列表比对,无序的SQL比较复杂速度慢且占内存大容易崩
3、多步骤中间表存储过程
- 步骤多,SQL没有管道式游标必须写成中间表,数据频繁落地
- 不同条件下要采用不同计算规则,SQL只能分别遍历数据表
4、游标式复杂业务批处理
- 业务规则复杂,需要单条数据处理,SQL游标读数慢,且难以并行
- 反复查询其它数据表获取计算规则和依据,大量重复动作,鼐计算方案原始
现实业务中复杂SQL(及存储过程)动辄数百上千行,大量迂回思路才能完成运算,代码复杂、性能低下
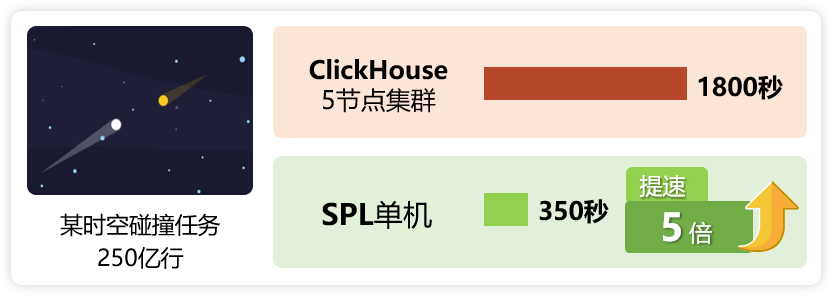
时空碰撞问题:关联分类处理
WITH DT AS ( SELECT DISTINCT id, ROUND(tm/900)+1 as tn, loc FROM T WHERE tm< 3*86400)
SELECT * FROM (
    SELECT B.id id, COUNT( DISINCT B.tn ) cnt
    FROM DT AS A JOIN DT AS B ON A.loc=B.loc AND A.tn=B.tn
    WHERE A.id=a AND B.id<>a  GROUP BY id )
ORDER BY cnt DESC LIMIT 20
| A | |
| 1 | >NL=100000,NT=3*96 |
| 2 | =file("T.ctx").open() |
| 3 | =A2.cursor(tm,loc;id==a).fetch().align(NL*NT,(loc-1)*NT+tm\900+1) |
| 4 | =A2.cursor@mv(;id!=a && A3((loc-1)*NT+tm\900+1)) |
| 5 | =A4.group@s(id;icount@o(tm\900):cnt).total(top(-20;cnt)) |
为什么SQL跑不快,为什么SPL跑得快
硬件 ?
软件不能让硬件跑得更快,什么软件都不行!
算法 ✓
但可以设计出高效率低复杂度算法,计算量少了自然就快了
开发 ≠
光想出好的算法还不够,还要能开发出来才行
数据库 ✗
传统数据库受限于理论体系,想出好算法也很难实现
Q: 那咋办呢?
A: 往后看!
Q: 哦,原来是这样
A: 对咯,说破了不神奇
Q: 那找程序员去做呗
A: 没有这么容易滴
Q: 那不是只能干瞪眼吗?
A: 嘿嘿,大多数情况就是这样滴
因此 高性能计算 = 算法设计 + 算法实现 → 成为制约高性能计算的瓶颈
SQL无法实现高性能算法,而业务复杂时数据库优化引擎也不起作用,严重浪费计算资源
SPL可以轻松实现高性能算法,用更少的计算资源能跑出更高速的效果
高性能源泉:不止是代码,更是代数
类比 计算 1+2+3+…+100=?
普通人这么算
- 1+2=3
- 3+3=6
- 6+4=10
- 10+5=15
- 15+6=21
- …
高斯这么算
- 1+100=101
- 2+99=101
- 3+98=101
- …
- 一共有50个101
- 50*101= 5050
聪明的高斯想到了便捷高效的算法,这里的关键是:
使用了乘法 !
使用了乘法 !
SQL就象只有 加法的算术体系,代码冗长,计算低效
SPL则相当于发明了乘法!简化书写,提高性能
SQL的困难源于关系代数,理论问题无法用工程手段解决,虽然经过多年改善,面对复杂需求时依然困难重重
SPL基创新的代数体系:离散数据集,提供更丰富的数据类型和基础运算,拥有更强大的表达能力
SPL基创新的代数体系:离散数据集,提供更丰富的数据类型和基础运算,拥有更强大的表达能力
SPL部分高性能计算机制
遍历技术
延迟游标
※聚合理解
※有序游标
遍历复用
※多轮程序游标
特色关联
※外键指针化
※外键序号化
有序归并
※关联匹配过滤
※关联游标跳块
高速存储
※有序缓存
列式存储
※倍增分段并行
短数据类型
※主子同步分段
※ 这里许多算法和存储方案是SPL的独创发明!
04技术特性
运行环境
- JDK1.8 及以上JVM
- 任何操作系统,包括VM和Container,甚至Android
- 完整安装不足600M,核心包不足15M
- 资源消耗远比数据库小

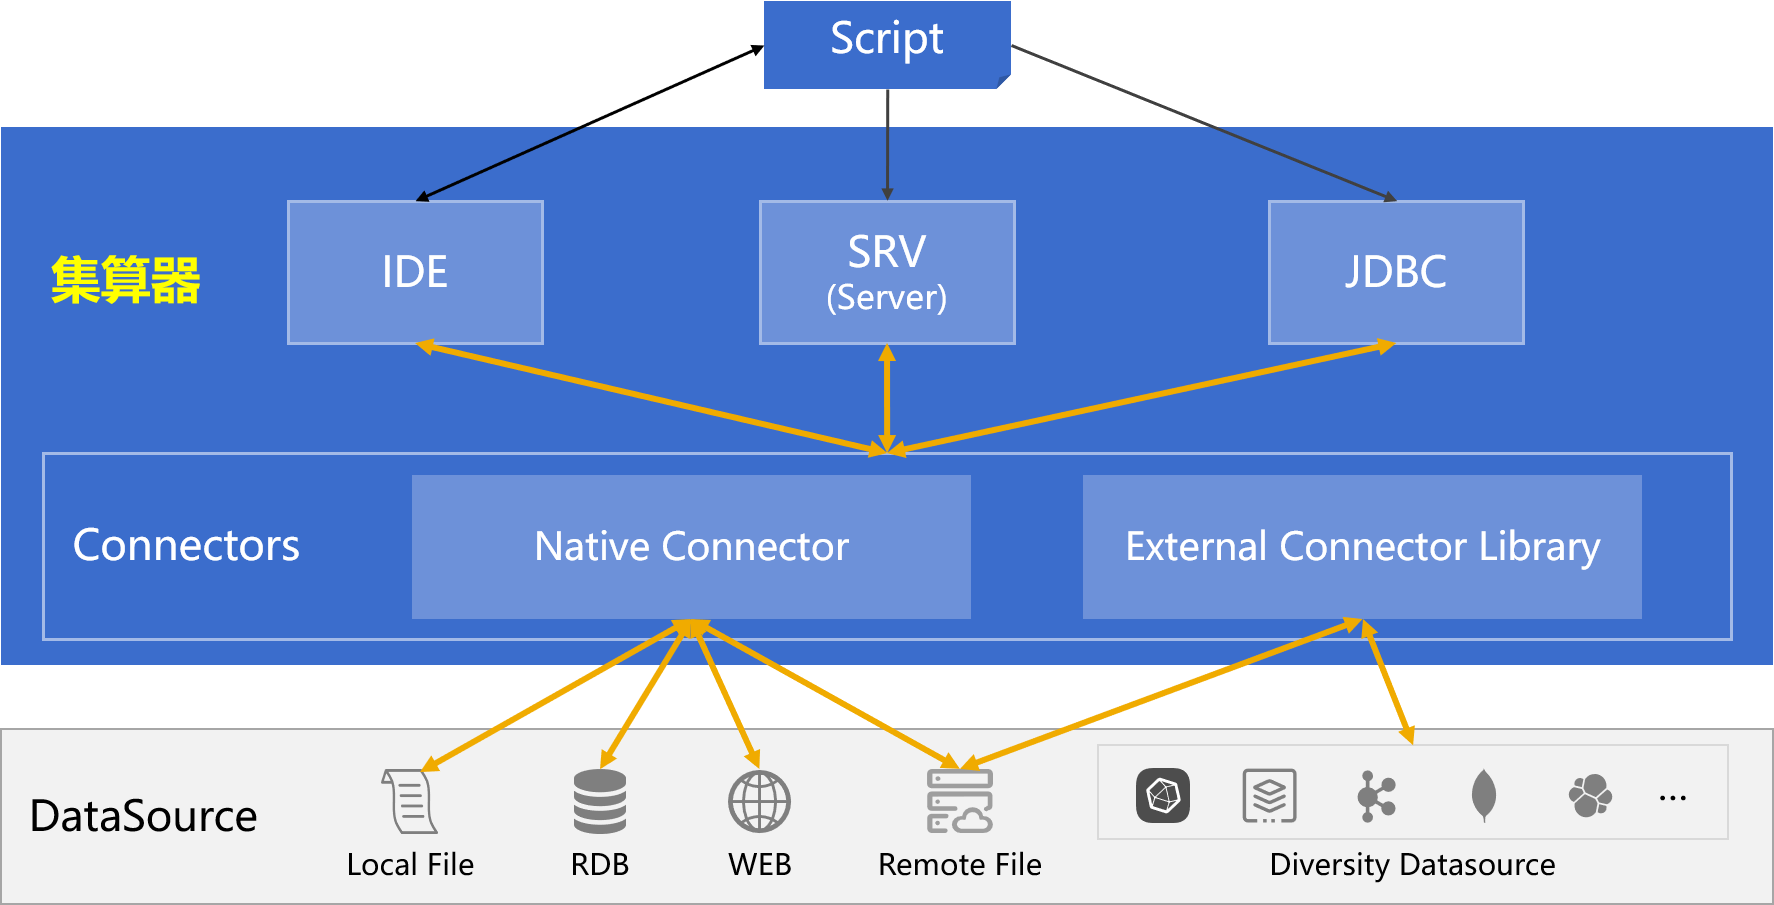
组成与概念
嵌入运行(Embedded)模式
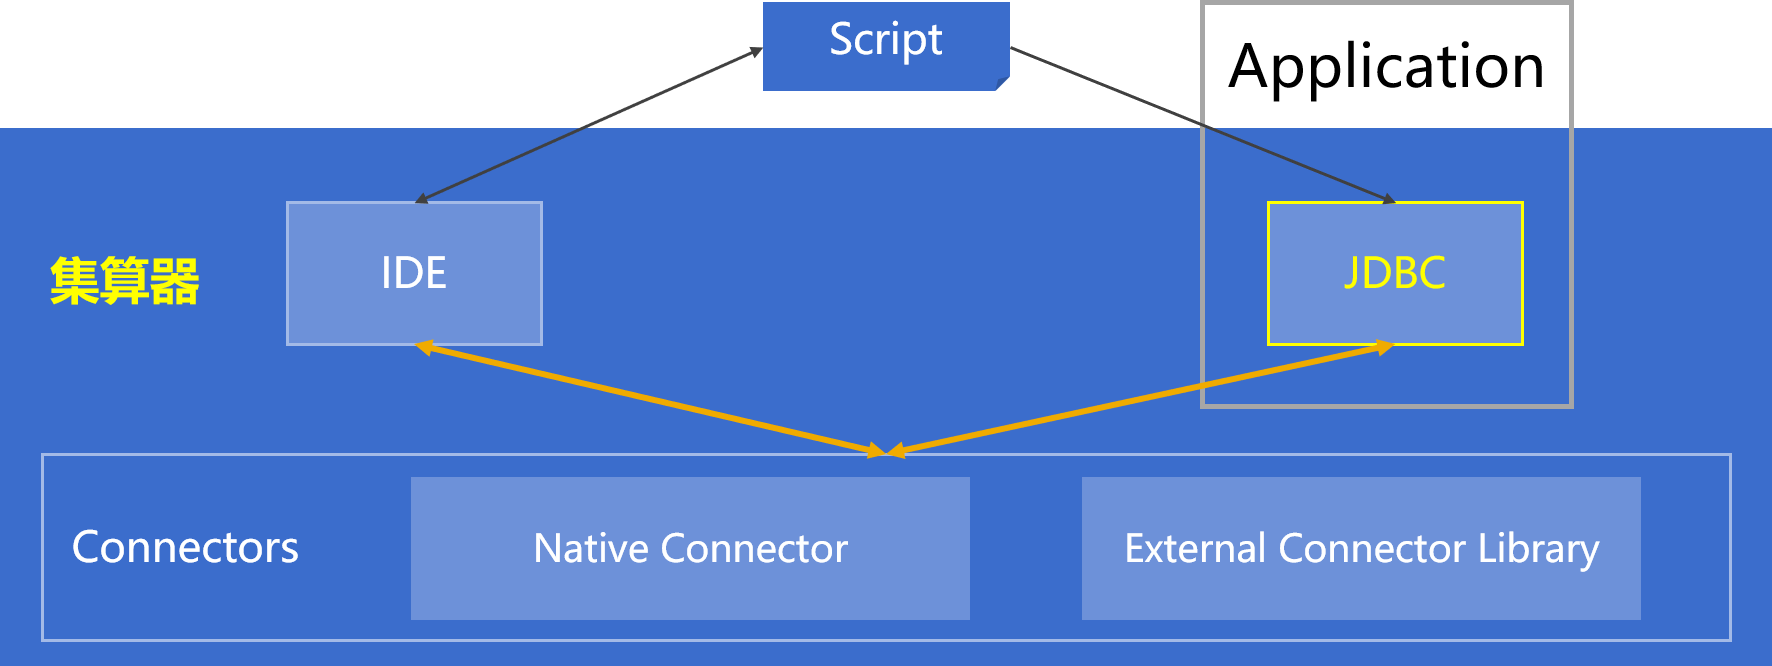
无需Server,集算器 JDBC具备独立计算能力,嵌入应用计算
极其与众不同的特点
独立运行(Server)模式
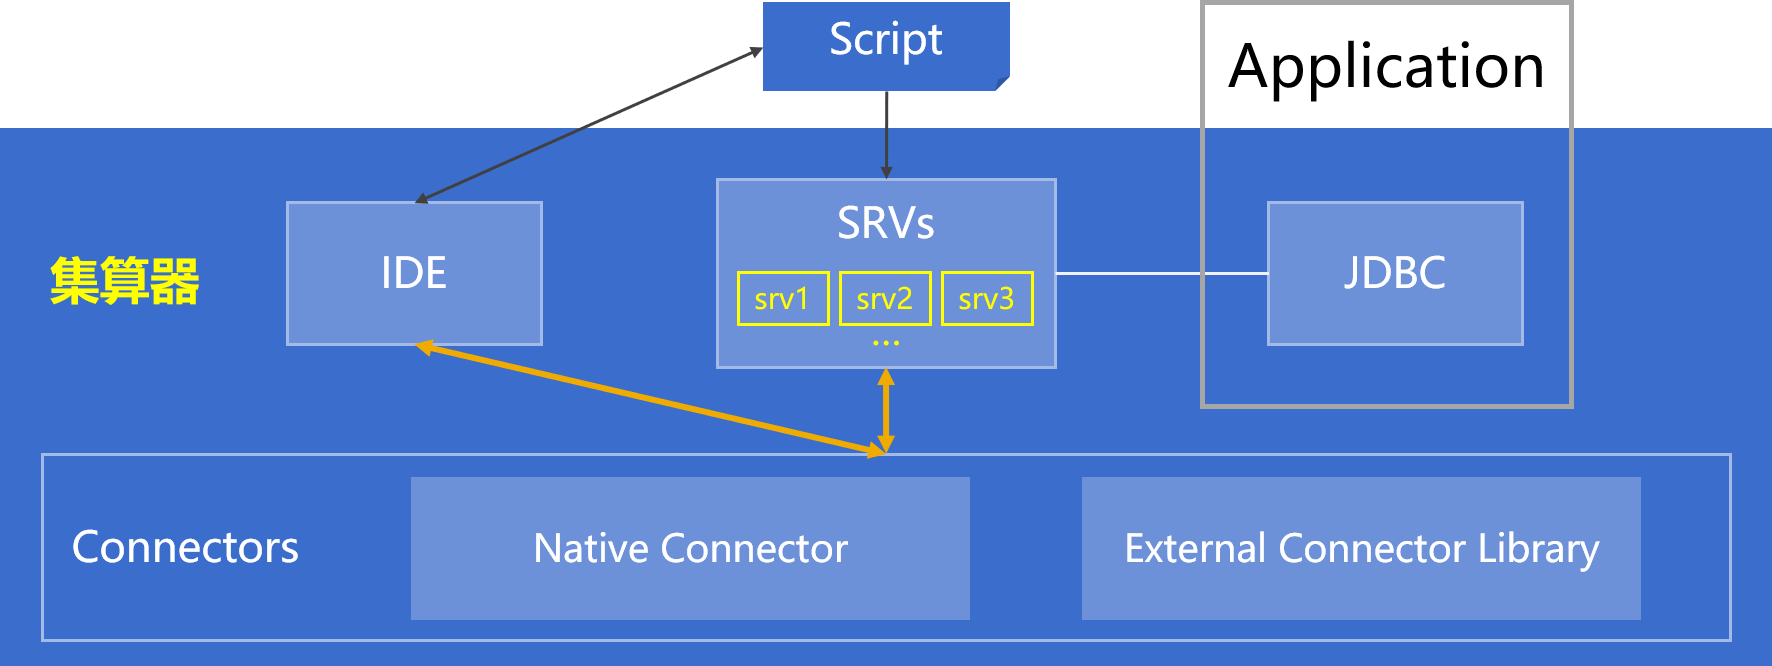
Server模式,独立部署,支持集群,提供负载均衡和容错机制
集算器 IDE
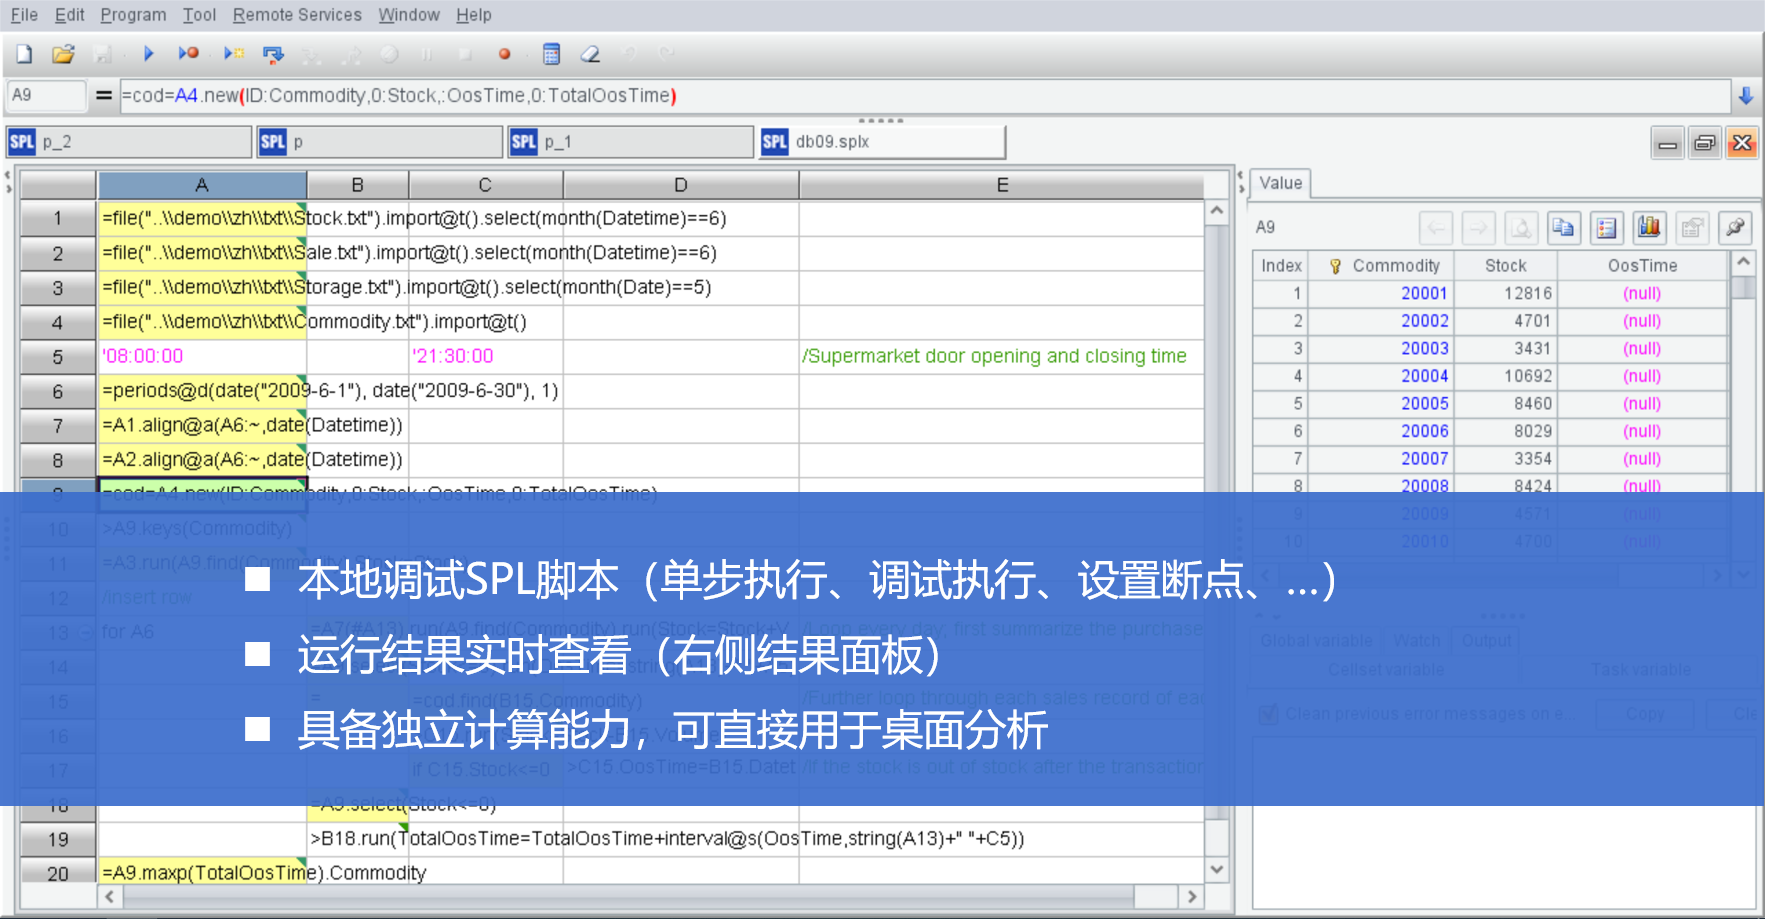
丰富的计算
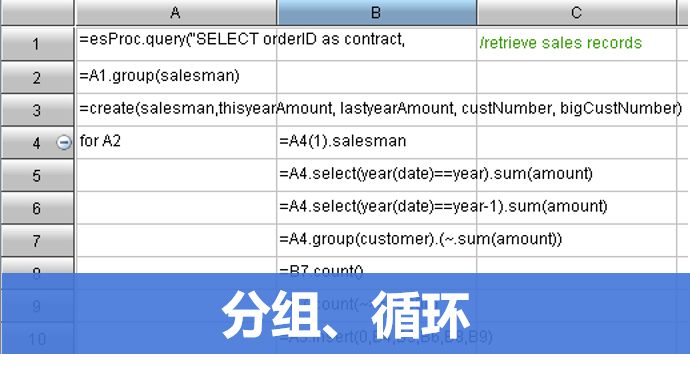
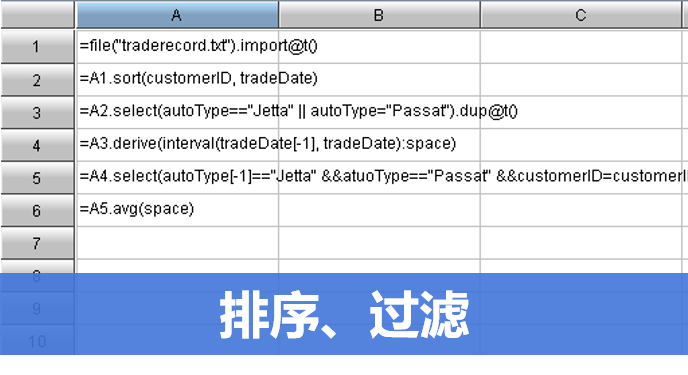
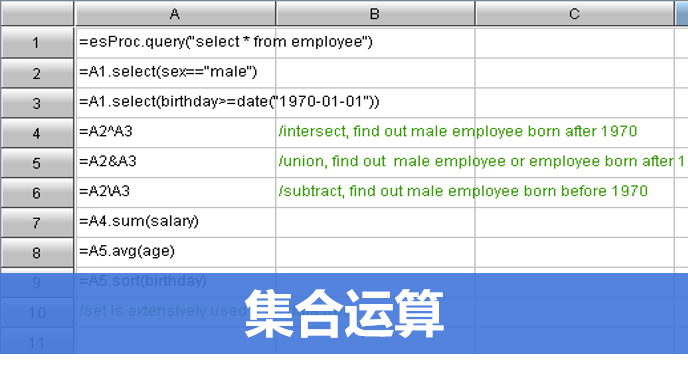
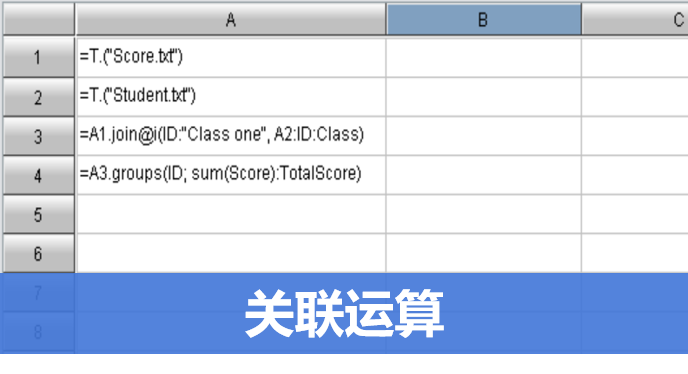
计算能力全部在集算器内部 ,不是翻译成SQL,也不可能
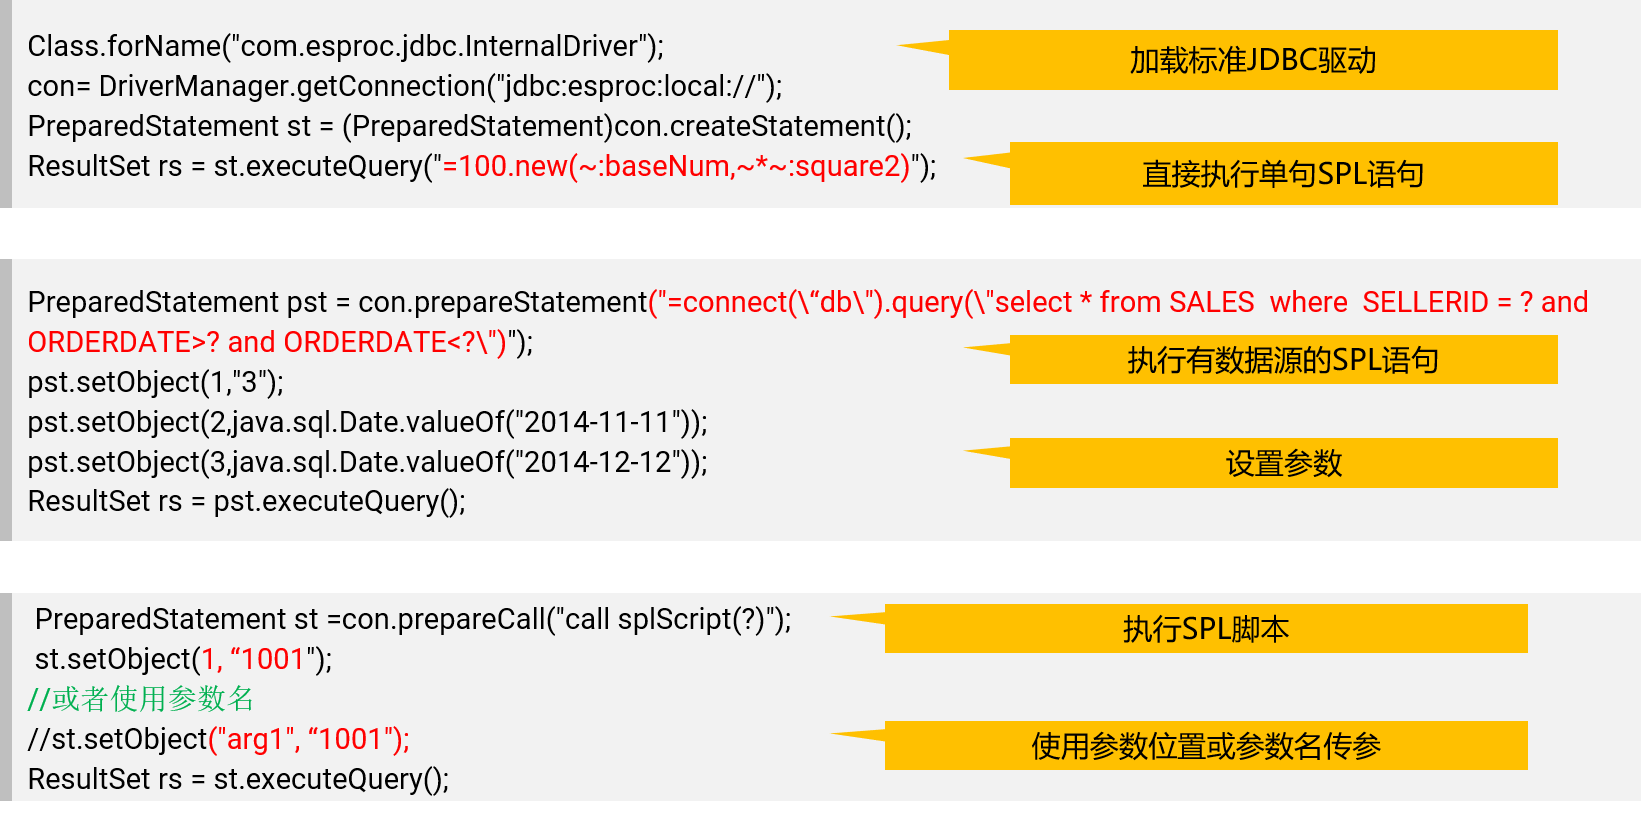
Java调用SPL
存算分离
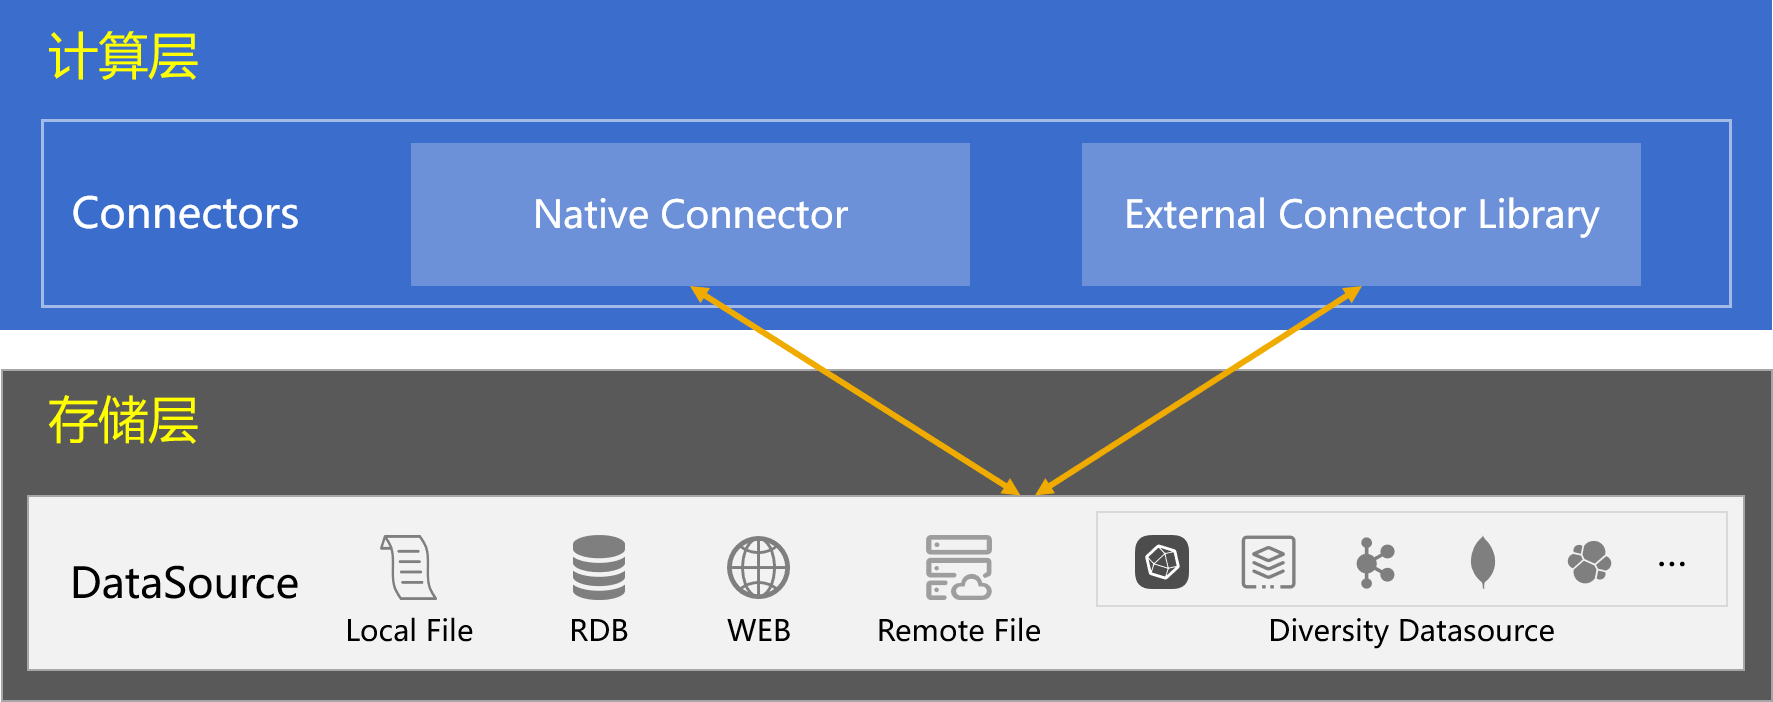
所有数据源逻辑等同,集算器不拥有数据(仅计算),天然存算分离
没有库内库外概念,无须入库出库动作
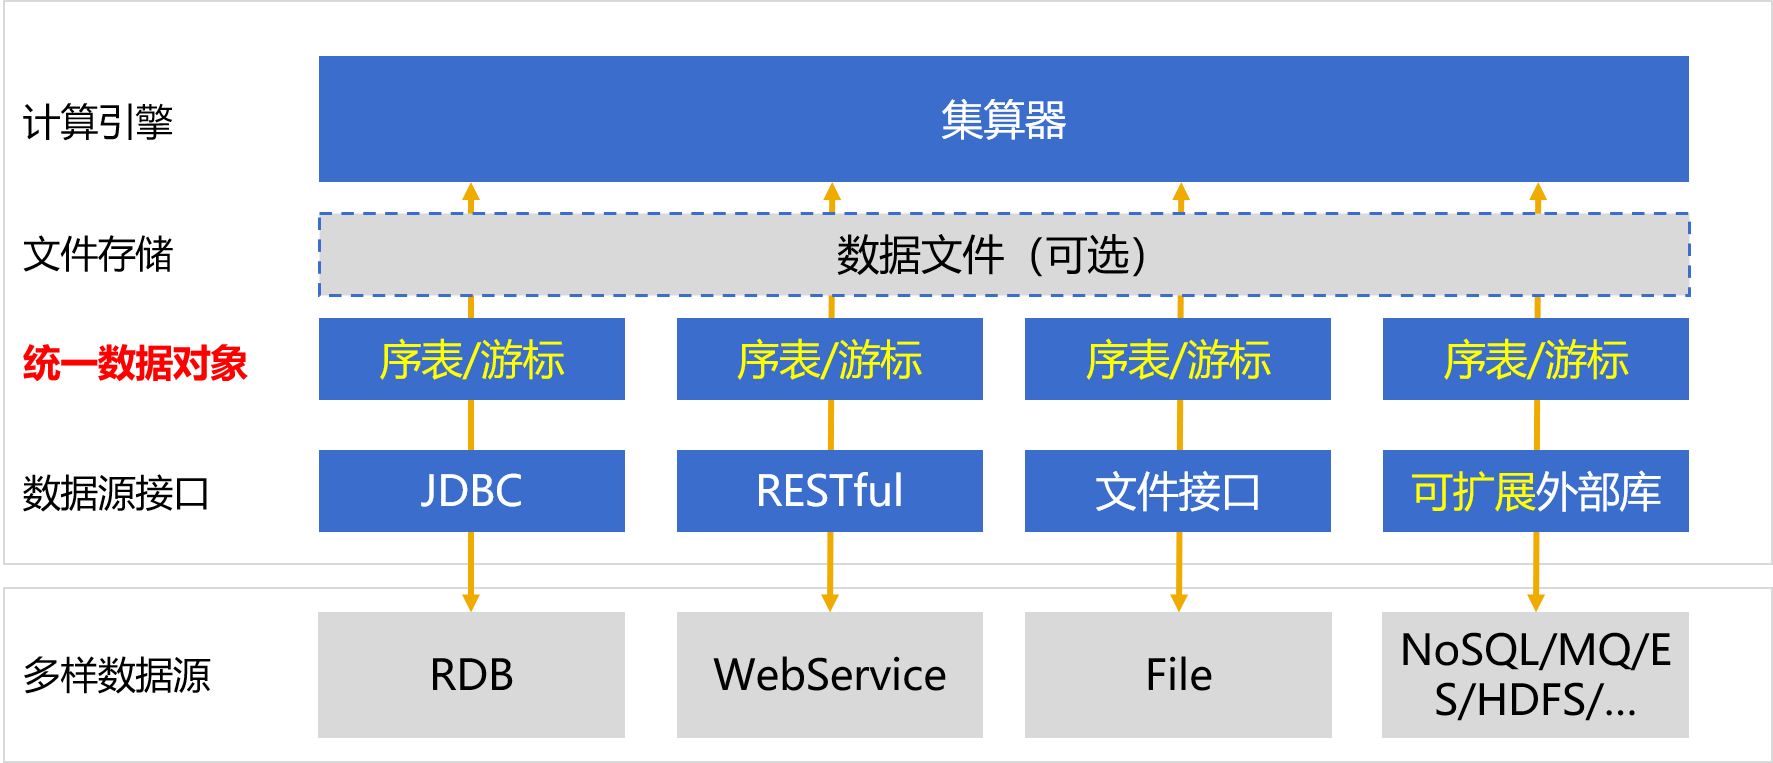
多样性数据源与混算支持
集算器拥有独立且完备计算能力,不依赖数据源,任何数据源都能读取并混合计算
支持数据源种类
多数据源混合计算-小数据
| A | |
| 1 | =connect("mysql") |
| 2 | =A1.query@x("SELECT o.order_id, o.user_id, o.order_date, oi.product_id, oi.quantity, oi.price FROM orders o JOIN order_items oi ON o.order_id = oi.order_id WHERE o.order_date >= CURDATE() - INTERVAL 1 MONTH") |
| 3 | =mongo_open("mongodb://127.0.0.1:27017/raqdb") |
| 4 | =mongo_shell@d(A3, "{ 'find': 'products', 'filter': { 'category': { '$in': ['Tablets', 'Wearables', 'Audio'] } }}” ) |
| 5 | =A2.join@i(product_id,A4:product_id,name,brand,category,attributes) |
| 6 | =A5.groups(category;sum(price*quantity):amount) |
MySQL与MongoDB混算
多数据源混合计算-大数据
| A | |
| 1 | =connect("mysql") |
| 2 | =A1.cursor@x("SELECT o.order_id, o.user_id, o.order_date, oi.product_id, oi.quantity, oi.price FROM orders o JOIN order_items oi ON o.order_id = oi.order_id WHERE o.order_date >= CURDATE() - INTERVAL 1 MONTH ORDER BY oi.product_id ASC") |
| 3 | =mongo_open("mongodb://127.0.0.1:27017/raqdb") |
| 4 | =mongo_shell@dc(A3,"{ 'find': 'products', 'filter': {}, 'sort': { 'product_id': 1 }}") |
| 5 | =joinx(A2:o,product_id;A4:p,product_id) |
| 6 | =A5.groups(p.category;sum(o.price*o.quantity):amount) |
MySQL与MongoDB混算
集算器文件存储
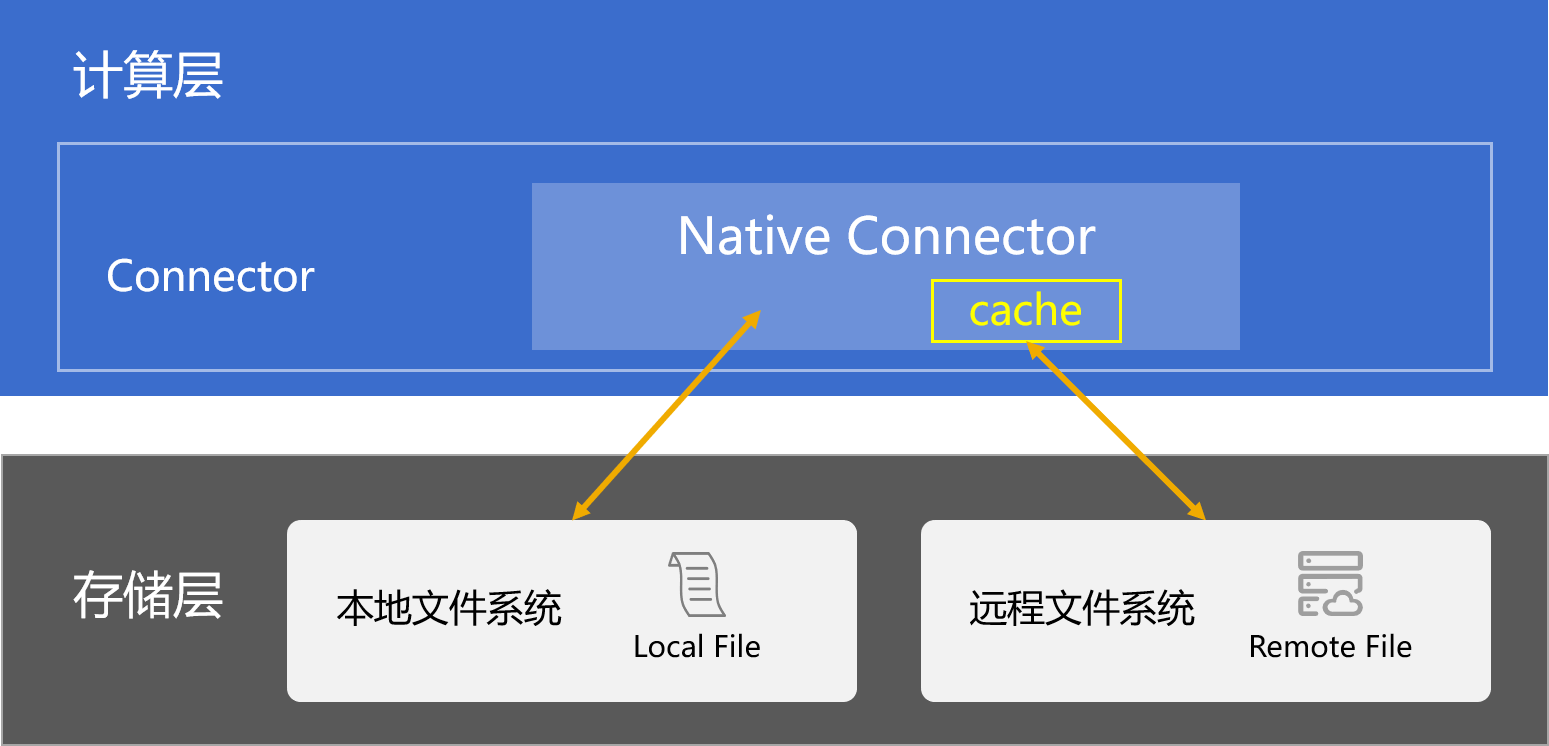
数据以文件格式缓存,充分保障计算性能
高性能文件格式
集文件
二进制文件,结构简单,无需定义结构
应用场景:
数据转储中介、临时存储、 小数据存储
组表
行列混合存储,支持索引,需事先定义结构
应用场景:
大数据存储、高性能计算
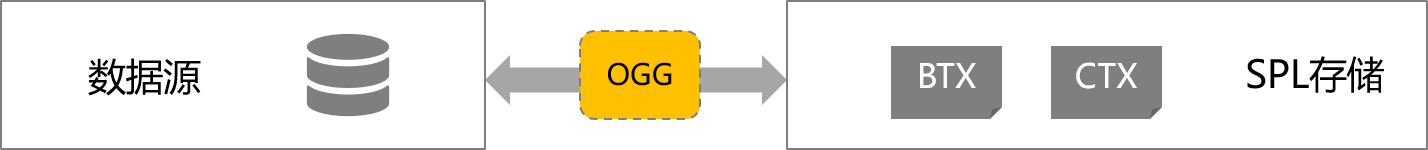
数据组织与交换

- 所有能被访问的数据都能直接参与计算,
- 数据缓存成集算器格式文件(可用SPL实现)可以获得更高访问和计算性能
数据组织与交换
小数据
| A | |
| 1 | =connect(“db") |
| 2 | =A1.query@x("SELECT AREAID,AREANAME FROM AREA ORDER BY AREAID") |
| 3 | =file("area.btx").export@b(A2) |
大数据
| A | |
| 1 | =connect(“db") |
| 2 | =A1.cursor("select ORDERID,CUSTOMERID,EMPLOYEEID,AREAID,AMOUNT,ORDERDATE from ORDERS") |
| 3 | =file("orders.ctx").create@y(ORDERID,CUSTOMERID, EMPLOYEEID,AREAID,AMOUNT,ORDERDATE) |
| 4 | =A3.append(A2) |
| 5 | >A1.close(),A3.close() |
应用结构
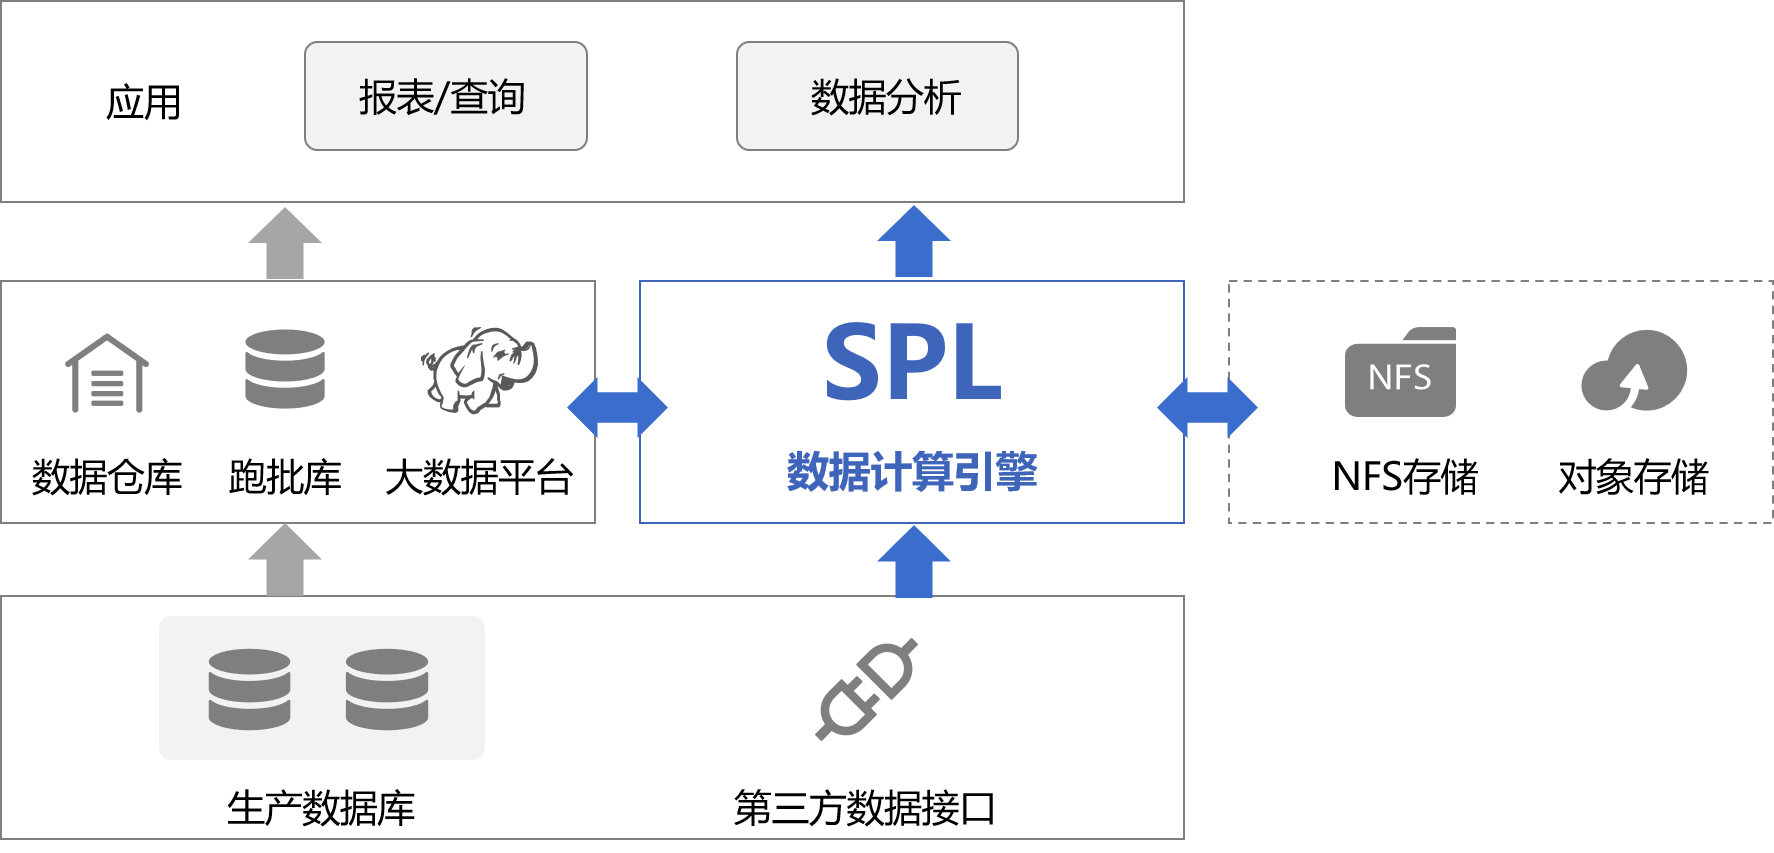
05应用场景(大数据、中间件)
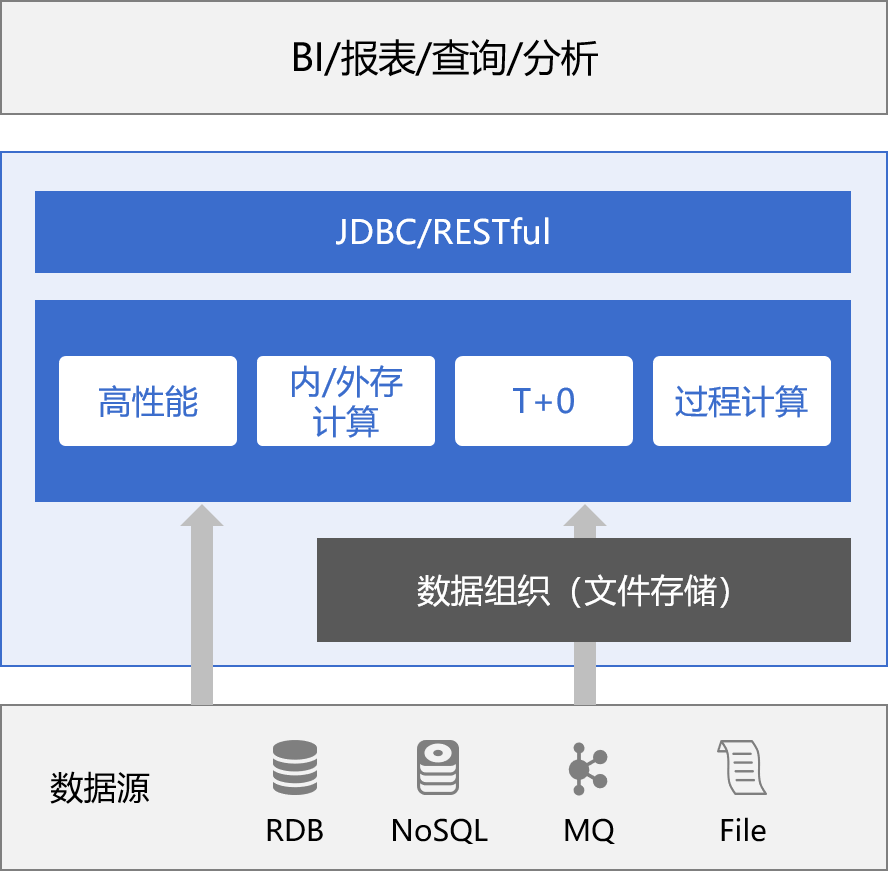
OLAP数据库/内存数据库
- 高性能算法克服SQL缺陷,避免宽表
- 全面内外存计算技术,覆盖内存数据库功能
- 开放体系接入生产数据源实现T+0全量查询
- 复杂报表/过程计算,简单技术栈
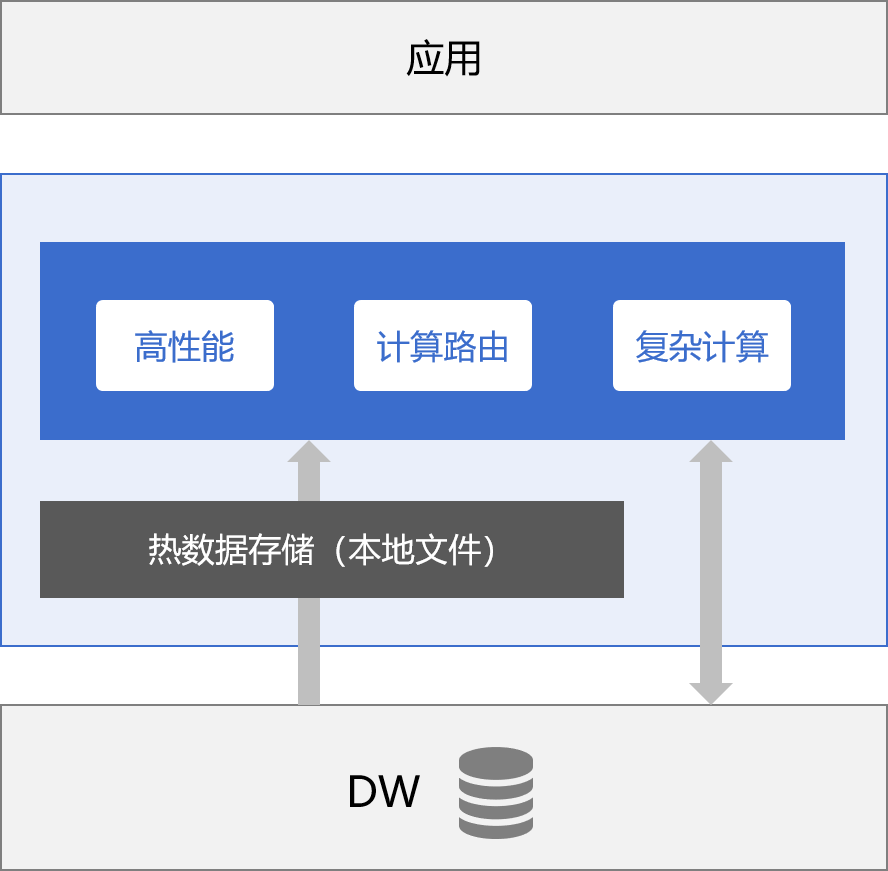
前置数据库
- 高性能轻量级前置数据库
- 可编程计算路由模拟全量数据计算
- 全面复杂计算,避免应用层编程
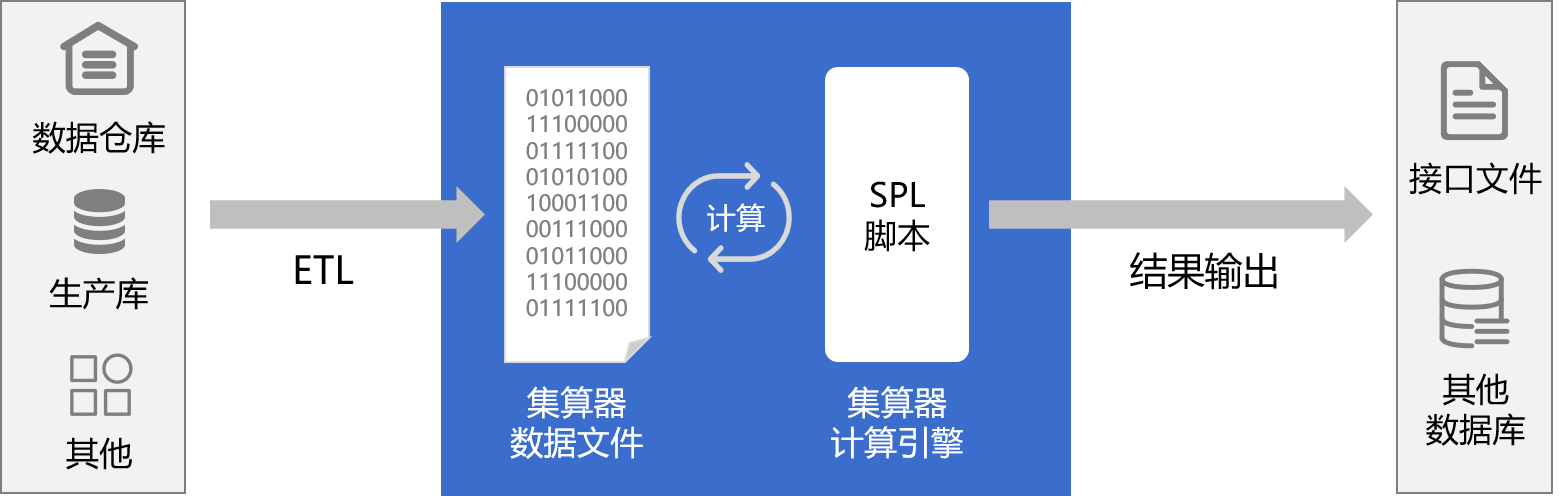
跑批数据库/ETL
- 无数据入库出入成本,数据源直接访问
- 高性能算法克服SQL缺陷
- 并行游标实现复杂过程计算
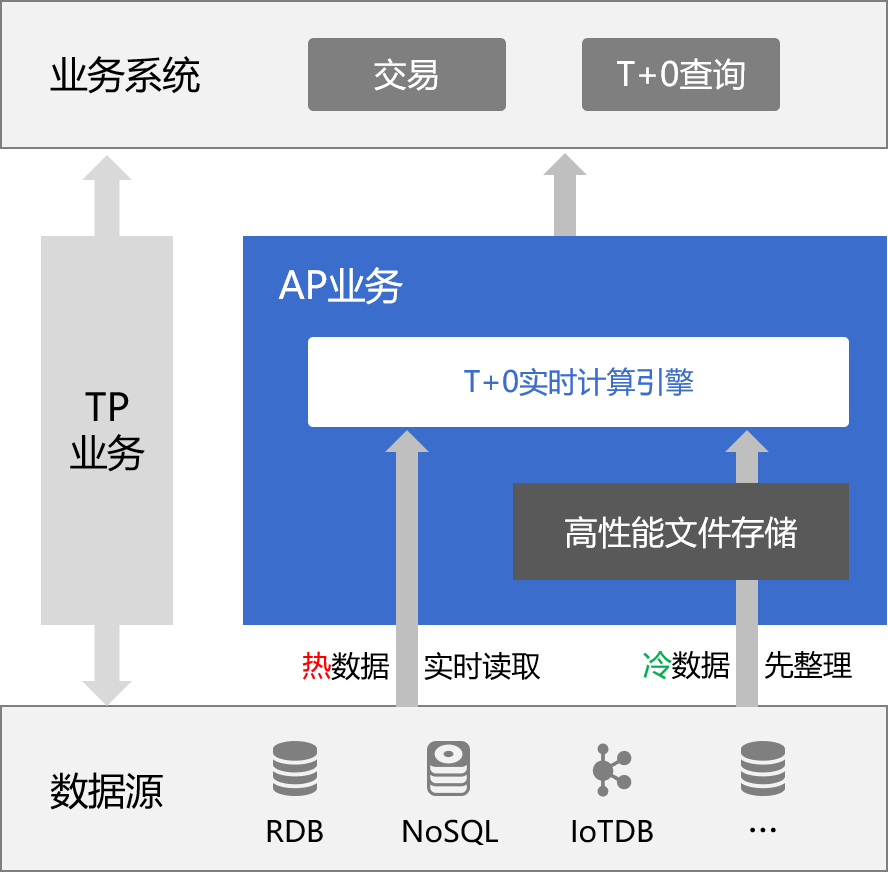
HTAP解决
- 继续现有TP方案,保持原有数据源优势,减少迁移风险
- 允许精心整理历史数据,用冷热混合计算实现高性能AP
- 轻松实现T+0查询
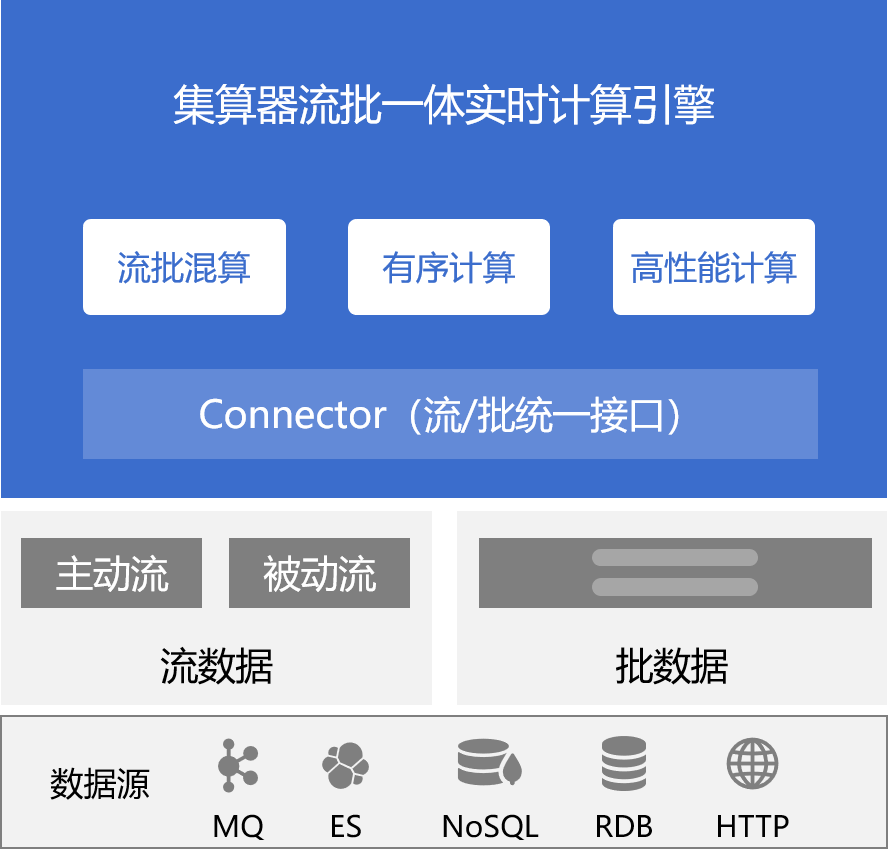
实时流计算
- 流批一体计算体系
- 双向流数据接口:主动获取,被动接收
- 多样性数据源支持
- 轻架构,无须复杂的流计算框架
- 强大的有序计算特别适合流数据
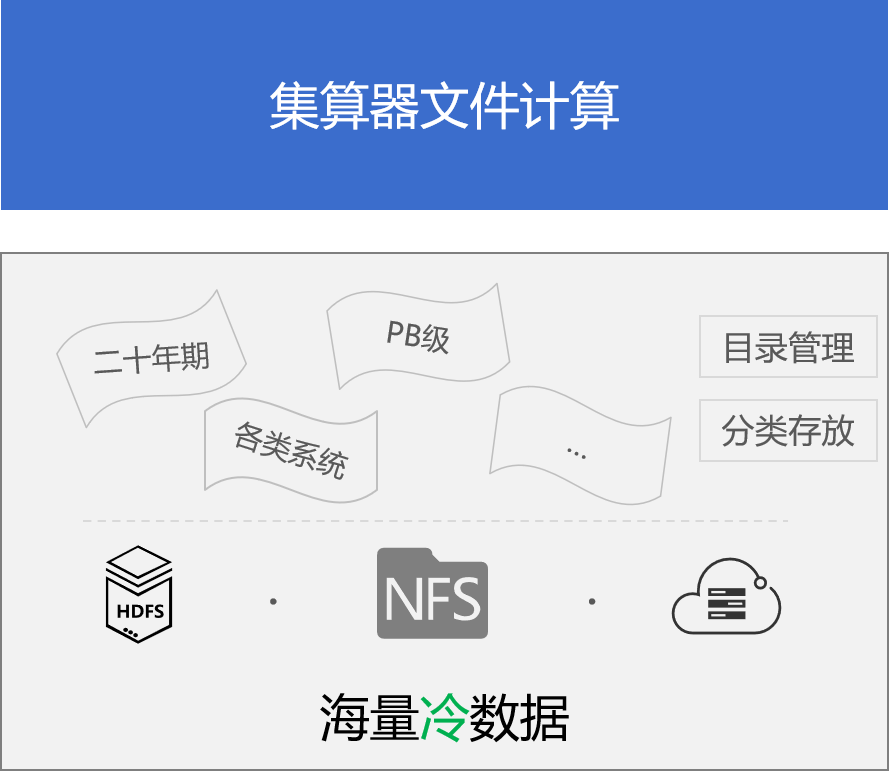
冷数据的热计算
- 历史冷数据装入数据库占用空间,导致运维复杂化,成本高昂,使用频率却很低,但不装入又不能计算
- 临时装入效率低,装入时间远超计算时间
- SPL直接基于文件计算,无需入库,数据不再“冷” ,低廉存储成本提供热计算
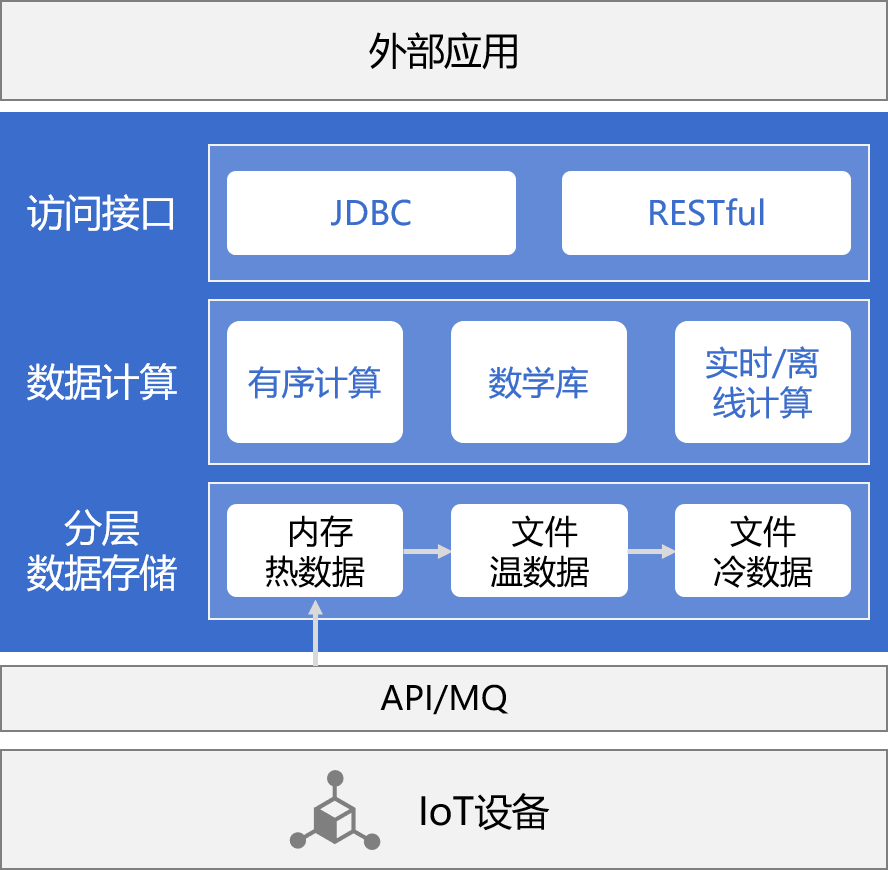
轻量分层时序数据计算
- 热温冷多层存储模式,解决高频写入和大数据查询的矛盾
- 有序计算支持特别适合时序数据计算,克服SQL缺点
- 提供向量、矩阵、拟合、建模等数学库,简化技术栈
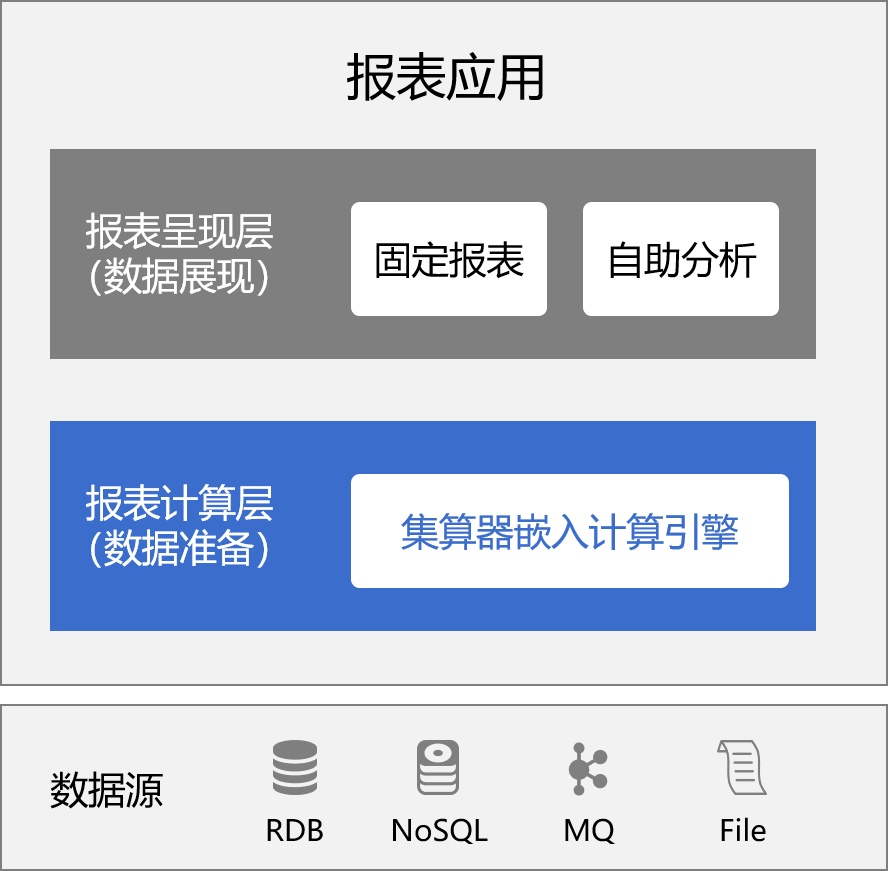
报表查询数据准备层
- SPL敏捷计算提升开发效率,避免复杂SQL和存储过程
- 不依赖于数据库的计算能力,代码跨库移植
- 解释执行,天然热切换,报表模块与应用解耦
- 低成本应对没完没了
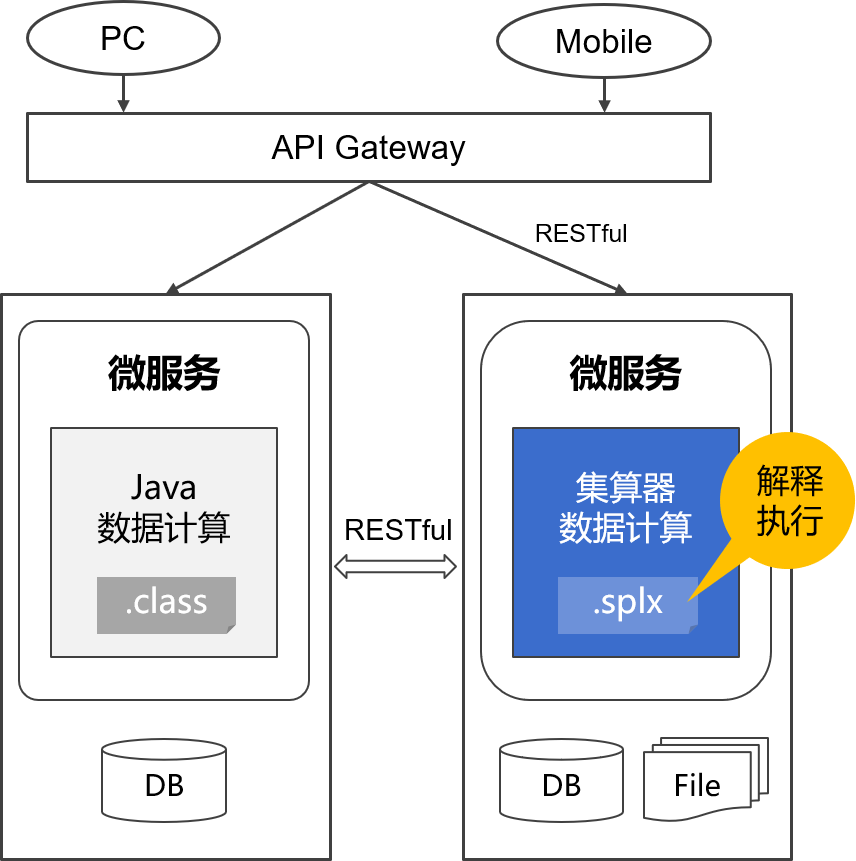
Java数据逻辑/微服务实现
- 纯Java,和主应用一起打包享受Java成熟框架优势
- 敏捷开发,全面替代Stream/Kotlin/ORM
- 不依赖于数据库的计算能力,代码跨库移植
- 解释执行,热切换,低耦合
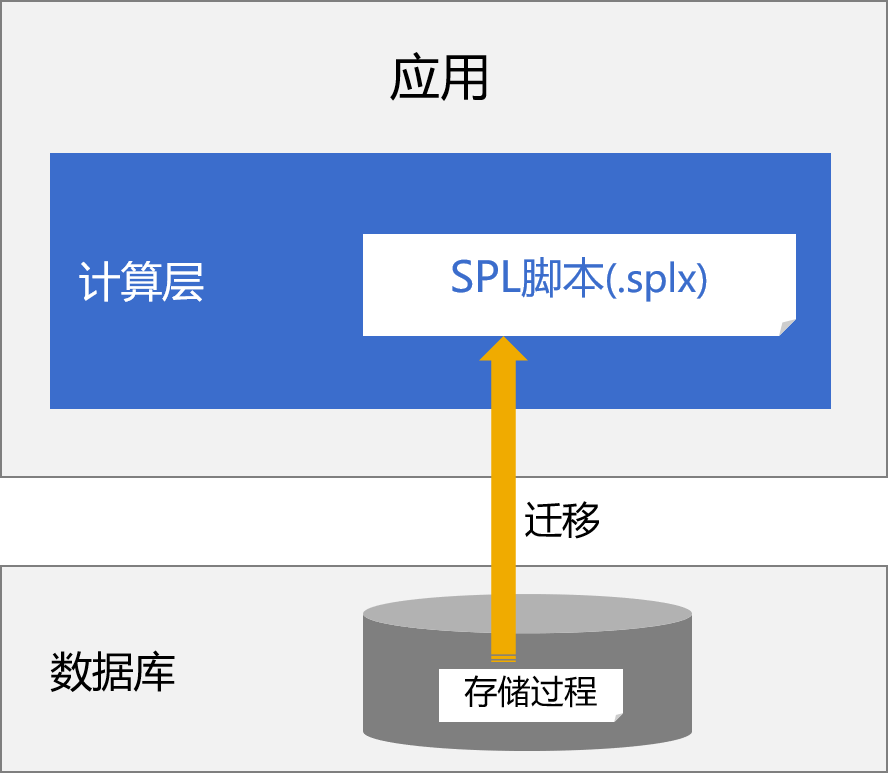
存储过程替代及功能实现
- 纯Java,和主应用一起打包享受Java成熟框架优势,克服存储过程缺点
- 强大过程计算,易于调试,更高开发效率
- 库外计算,不依赖于数据库,天然可移植
- 无须编译存储过程权限,同时避免应用间耦合,提升安全性和可靠性
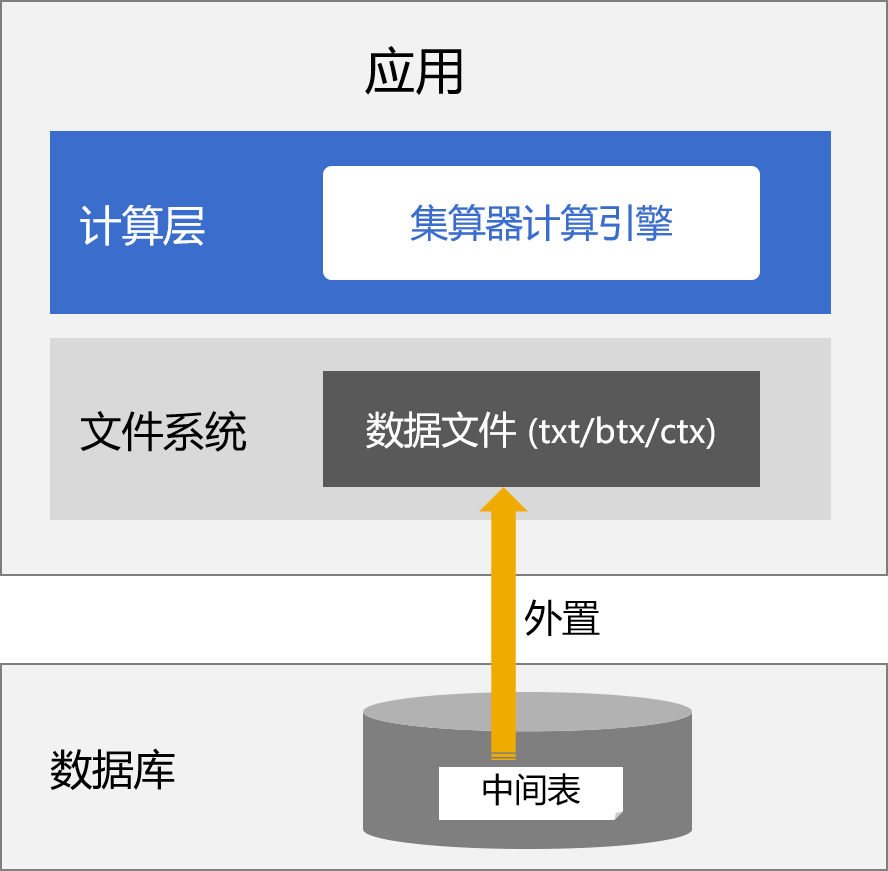
数据库减负/消灭中间表
- 非关键中间数据移出数据库存入文件,减少数据库存储负担
- 树状目录更易于管理,降低应用间耦合
- 计算任务移出库外实现,减少数据库计算负担
- 文件访问性能更高,运算性能大幅提高
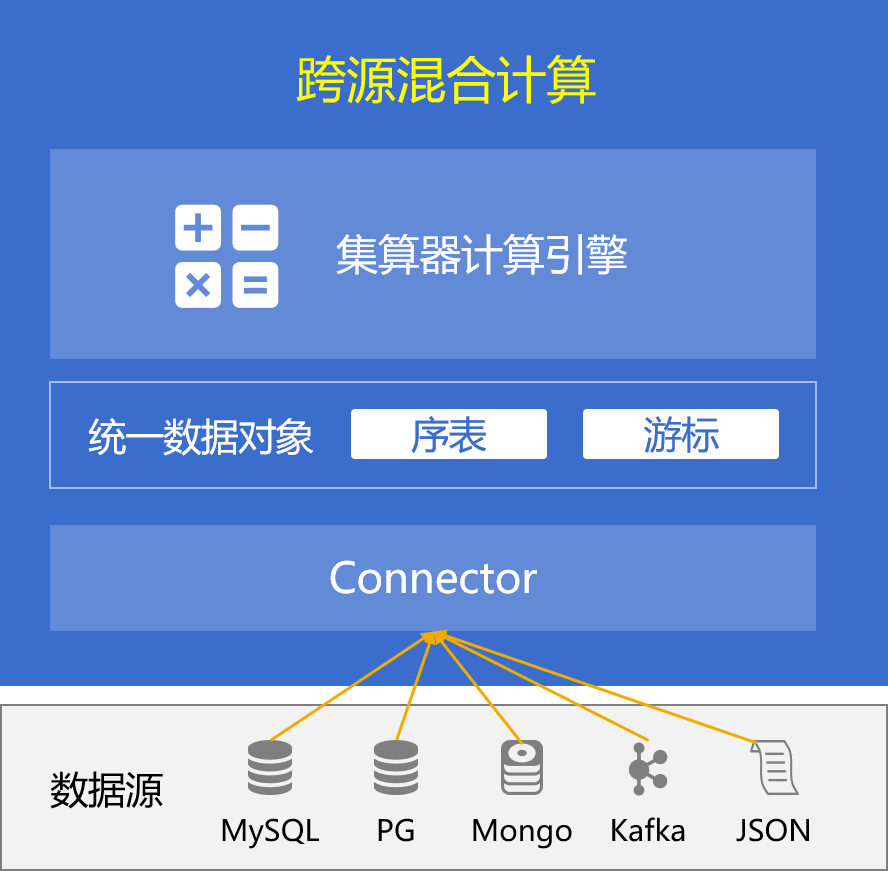
多样数据源混算/T+0实时全量统计
- 丰富数据源支持:RDB,NoSQL,File,HTTP,...;json等多层数据
- 直接计算,无须入库,保持实时性
- 异构数据库跨库计算,生产库+分析库混合计算实现T+0统计
- 不依赖于数据源的计算能力,天然可移植
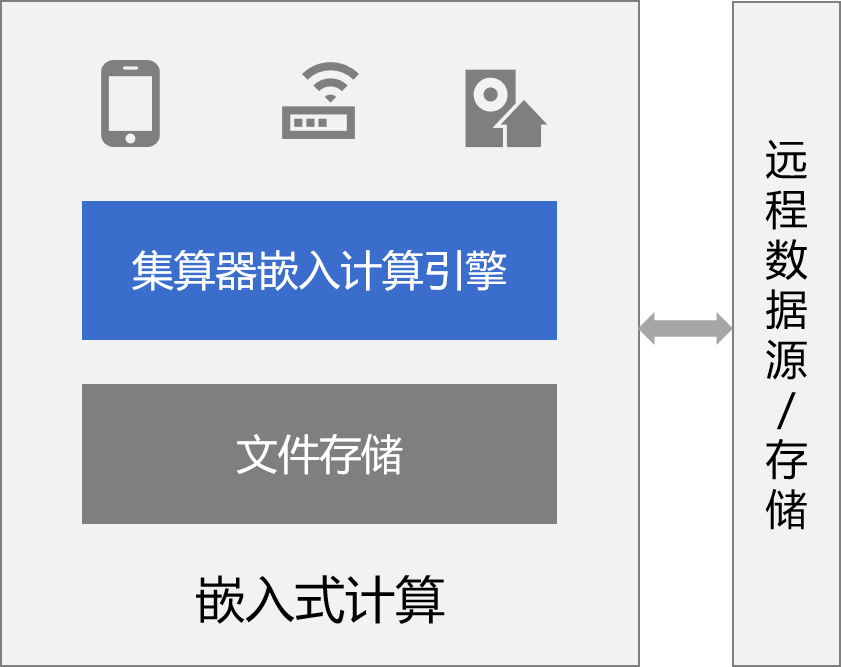
嵌入/边缘计算引擎
- 小体积全嵌入,可用于边缘计算场景
- 全面计算功能,包括数学类库,大部分任务无须其它组件
- 简单文件存储,无须数据库
- 可接驳远程大型数据源和存储装置
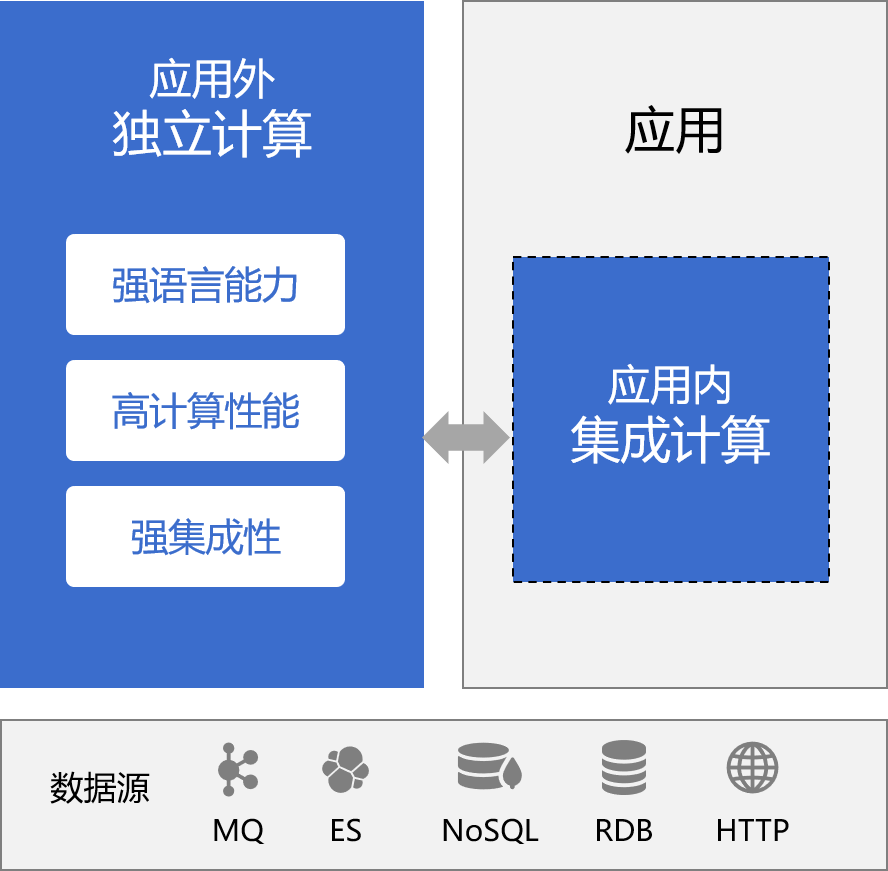
应用外数据清洗准备
- 数据源支持丰富而且一致,方便访问各种无SQL的数据源
- 语言能力强,描述复杂运算比Python更为简捷
- 并行计算,处理大数据时方便性和速度远超Python
- 强集成性,必要时可转移成应用内计算
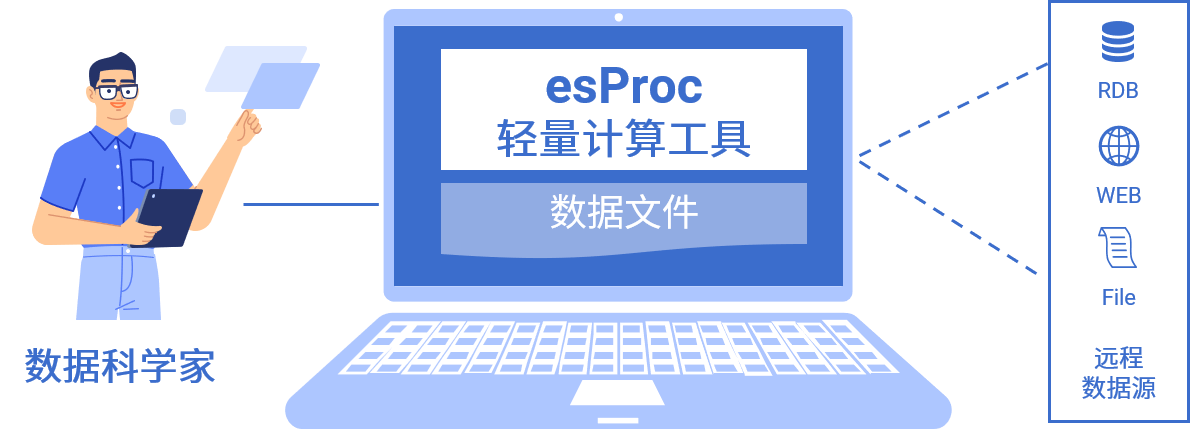
数据科学家探索分析
- 语言能力强,描述复杂运算比SQL和Python更为简捷
- 比SQL和Python更强的交互性,调试更方便
- 文件存储,数据独立便携,无须数据库就可以分析手边数据
- 并行计算,处理大数据量时方便性和速度远超Python
06常见问题
集算器基于开源或数据库技术吗?
集算器基于全新的计算模型,无开源技术可以引用,从理论到代码全部自主创新

基于创新理论的集算器不能再使用SQL实现高性能,SQL无法描述大部分低复杂度算法
集算器可以部署在哪里?
集算器 完全用纯Java开发,可以在任何有JVM的操作系统下运算,包括虚拟机、云服务器以及容器,甚至可以运行在Android 上。
应用程序如何调用集算器?
集算器 提供了标准的JDBC驱动,可被Java应用无缝集成调用。
对于非Java应用,集算器提供了HTTP/RESTFul调用接口。
集算器能与其他框架集成吗?
作为拥有良好集成性的Java产品,可以无缝与各种 Java 框架和应用服务器集成使用,其逻辑地位与自写的Java代码等同
对于计算型框架(比如 Spark),虽然集算器能被无缝集成,但并没有实际意义,集算器可以替代Spark计算
特别地,集算器自有流式计算能力,不需要被流计算框架(比如 Flink)集成,通常会更好的功能和性能
集算器能基于现有数据库或其他数据源工作吗?
当然没问题! 集算器 支持几乎所有业界中常见的数据源,可以直接使用数据源本身的接口和语法,不需要将数据源映射成关系数据库表。
不过,因为数据库I/O性能不佳, 集算器这时不能保证高性能, 而且数据库或其他数据源通常也不提供低复杂度算法需要的存储。要获得高性能,推荐使用集算器的自有格式文件来存储。
集算器把数据存在哪里?
集算器不拥有数据,原则上并不负责数据存储,可访问到的数据都可以计算。
特别地,集算器对文件支持非常好,数据文件可以存储在任何文件系统中,包括网络文件系统和云上对象存储。,天然实现存算分离机制。
集算器高可用如何保障?
嵌入应用使用时,可靠性由应用保障
独立使用时,提供负载均衡和容错机制,但单任务可能失败,仅适合小规模集群
不提供故障后自动恢复功能
云版本的弹性计算机制在分配 VM 时会避开当前失效的节点,一定程度实现高可用
集算器如何进行功能扩展?
可使用提供的接口,调用 Java 写的静态函数来扩展功能
集算器也开放了自定义函数的接口,注册后即可在SPL中使用
集算器有什么不足吗?
和RDB相比
集算器没有元数据,大部分计算要从访问数据源(文件)开始,对于特别简单的运算反而会有些麻烦。
和Hadoop/MPP相比
集算器提供有集群能力,但缺乏机会历练。
历史上,集算器多次用单机替代原有的集群,仍获得同样甚至更高的性能。
和Python相比
SPL 正在发展人工智能类库,但目前和Python相差还比较远。
SPL与SQL兼容性如何?
SPL不是 SQL 体系的计算引擎,目前仅支持小数据量下的简单SQL且不保障性能。可以认为集算器不支持SQL,当然也不会和任何SQL及存储过程兼容。
有没有将SQL自动转成 SPL的工具?
目前还没有。
SQL语句的信息不足, 需要猜出其目标才能设计合理的优化路径。我们优化SQL的经验远不如传统数据库厂商,这时候直接把SQL转换成SPL通常会导致更差的性能。
SPL有多难学?
SPL专门用于低代码和高性能
SPL语法很容易,有Java/SQL基础者只要数小时即可入门,数周就能熟练
“难”,高性能算法有点难, 需要学习更多算法知识
“不难”,一旦学会,很多高性能任务都成为“套路”
如何启动性能优化项目?
最初的1-2个场景,由我方工程师介入配合用户实现
大多数程序员习惯了SQL思维方式,不熟悉SPL的思维方式,需要用一两个场景训练和理解
性能优化套路经历过也就学会了,算法设计和实现并不是那么难

授人以鱼不如授人以渔!
07优势总结
集算器优势总结
5 大优势
性能卓越
大数据处理速度比传统方案平均提高1个数量级
高效开发
语法过程化,符合自然思维
丰富类库
灵活开放
多源混合计算
独立、嵌入多种应用方式
资源节省
单机顶集群,减少硬件开销
绿色环保
成本锐减
开发、硬件、运维成本降低X倍